AIニュース
Claude Sonnet 5.5はAstra超え?Opus 5.5級のベンチマーク・料金・使い分けを徹底解説
「Sonnetは、Opusより軽い仕事を任せるAI」――その見方を、見直すきっかけになる新モデルが登場しました。
2026年9月28日、Anthropicが「Claude Sonnet 5.5」をリリースしました。注目は、単に前のSonnetより賢くなったことではありません。仕事の成果物を評価するテストではOpus 5.5に肉薄し、ターミナルを使う開発作業のテストでは上回る結果も出ています。
さらに、第三者評価機関Artificial Analysisの総合指標では、Sonnet 5.5のMax設定が56点。GPT-6 AstraのMax設定の53点を上回りました。「Sonnetなのに、Astra超え?」と驚く理由は、実際の評価データにあります。
ただし、ここには大切な条件があります。最高スコアを出したSonnet 5.5は、推論に大量のトークンを使っています。「APIの単価が安い」と「仕事1件を安く終えられる」は、別の話です。
この記事では、公式の8指標比較、Astraを上回った評価の中身、料金とトークン消費、Opusとの使い分け、Claude CodeやAPIでの注意点まで、順番に解説します。ベンチマークに詳しくない方も、読み終えるころには「自分の仕事で試す価値があるか」を判断できるはずです。
情報確認日:2026年9月29日。発表日は公式モデル仕様に記載された日付です。数値はAnthropicとArtificial Analysisの公表値で、当社が同じ評価を再実行した結果ではありません。公式発表・公式モデル仕様
まず結論。Sonnet 5.5の何がすごいのか
今回の進化を、最初に4つに整理しましょう。
| 注目点 | 確認できたこと | 仕事で考えるときのポイント |
|---|---|---|
| Opusに迫る評価 | 文書・知的業務、画面操作、グラフ認識など、複数の指標でOpus 5.5に近い数値 | 日常の資料作りや、範囲が明確な実装で比較する価値がある |
| Astraを上回る総合指標 | Artificial AnalysisでSonnet 5.5 Maxは56、Astra Maxは53 | Max設定・同評価の範囲での結果。すべての仕事の優劣を意味しない |
| 価格を据え置き | 標準APIは入力100万トークン2ドル、出力10ドル | Opus 5.5の標準入出力単価の半分。ただし総費用は使用量にも左右される |
| 速さと作業効率 | AnthropicはSonnet 5より出力生成が30%以上速いと説明 | 出力速度の改善であり、どの仕事も所要時間が30%短くなる保証ではない |
ここでいう「ベンチマーク」は、AIへ共通の課題を与えて性能を測るテストです。プログラムの修正が得意か、資料を読めるか、画面を操作できるかなど、テストによって測る能力が変わります。
だからこそ、総合順位だけで選ぶより、自分が任せたい仕事に近いテストを見ると判断しやすくなります。Anthropic公式発表・Artificial Analysisの評価ページ
本当に「Astra超え」?第三者評価ではMax設定が56対53
結論からいうと、Artificial Analysis Intelligence Indexという総合指標では、Sonnet 5.5のMax設定がGPT-6 AstraのMax設定を上回っています。
2026年9月29日の確認時点で、公表されている丸め表示のスコアは次のとおりです。
| モデル・設定 | Intelligence Index | この比較の読み方 |
|---|---|---|
| Claude Opus 5.5・Max/既定フォールバック有効 | 58 | Sonnet 5.5より上 |
| Claude Sonnet 5.5・Max/既定フォールバック有効 | 56 | Astra Maxを上回り、Opus 5.5に迫る |
| GPT-6 Astra・Max | 53 | Sonnet 5.5より3点低い |
| Claude Sonnet 5.5・Xhigh/既定フォールバック有効 | 52 | 設定を変えると、Astra Maxとの順序も変わる |
出典:Sonnet 5.5の評価、GPT-6 Astra Maxの評価、Artificial Analysis公式発信。数値は公表画面の丸め表示で、順位・値は更新され得ます。
56点は「正答率56%」ではない
Intelligence Index v4.3.2は、知的業務、ツールを使う作業、科学的推論、長い文書の理解など、10種類の評価を組み合わせた指標です。単一テストの正答率ではありません。
56対53は、この指標上のスコア差です。「人間より何%賢い」「自分の仕事で必ず何%成果がよい」という意味には置き換えられません。
ここでいうフォールバックは、特定の要求で別モデルへ切り替わる仕組みです。Artificial Analysisは既定の切り替えを有効にして評価し、Sonnet 5.5では約0.1%の評価タスクでSonnet 5への切り替えを観測したと説明しています。評価機関の説明
また、MaxはAIが推論へ多くの計算を使う設定です。Sonnetというモデル名だけを見て、MediumやHighでも56点相当だと考えないことが重要です。Intelligence Indexの説明
評価機関自身が、トークン消費の大きさも指摘
紹介されているX投稿は、個人の感想ではなく、評価を実施したArtificial Analysisの公式発信です。そこで同時に指摘されているのが、Sonnet 5.5 Maxの出力トークン量です。
同機関は、Intelligence Indexの1タスク当たり約19.3万の出力トークンを使用し、その時点で測定した中で最多だったと説明しています。これはタスク内の複数の応答を含む集計で、1回の応答の出力上限ではありません。推論に使うトークンもあるため、画面に19万語の回答が表示されるという意味でもありません。
「Astraを上回るスコアを出した」というニュースは確かに大きい。一方で、それを日々の利用へ置き換えるときは、性能と、その性能を出すための使用量を一緒に見る必要があります。Artificial Analysis公式発信
SonnetなのにOpus級?公式8指標を並べると進化が見える
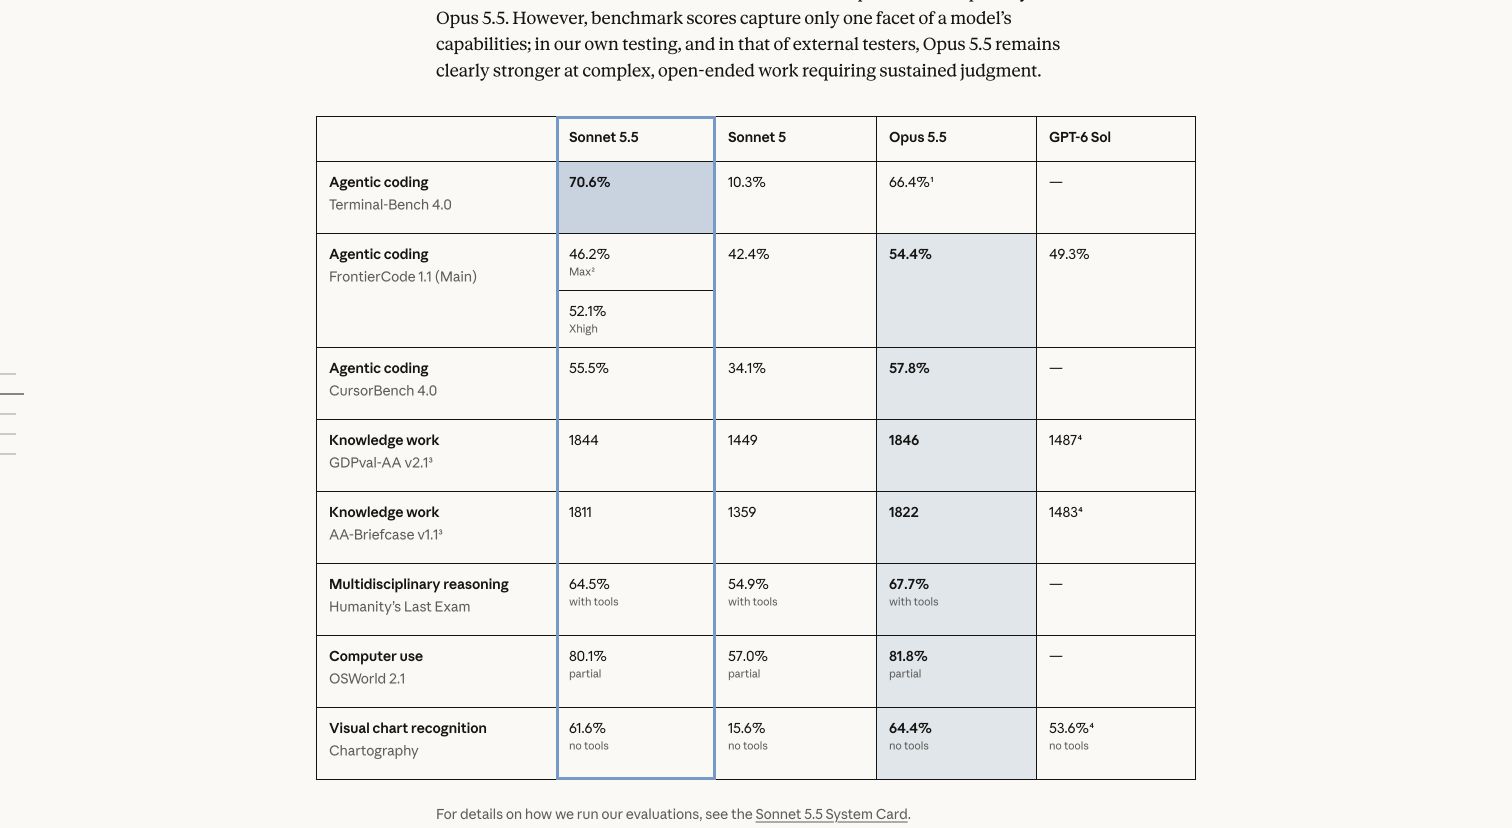
次の表は、AnthropicのSonnet 5.5発表ページに掲載された比較を、日本語で整理したものです。同じ表の中のSonnet 5・Sonnet 5.5・Opus 5.5を比較しています。
| 評価項目 | 何を測るか | Sonnet 5 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | ターミナルを使った複数工程の作業 | 10.3% | 70.6% | 66.4%※1 |
| FrontierCode 1.1 Main | 人の追加修正なしで取り込めるコード変更 | 42.4% | 52.1%〈Xhigh〉/46.2%〈Max〉※2 | 54.4% |
| CursorBench 4.0 | 実際の開発セッションに基づくコーディング | 34.1% | 55.5% | 57.8% |
| GDPval-AA v2.1 | 幅広い職業の実務成果物 | 1449 | 1844 | 1846 |
| AA-Briefcase v1.1 | 長い工程を伴う知的業務 | 1359 | 1811 | 1822 |
| Humanity’s Last Exam | 難しい専門的・学際的な問題 | 54.9% | 64.5% | 67.7% |
| OSWorld 2.1 | コンピューター画面の操作 | 57.0% | 80.1% | 81.8% |
| Chartography | グラフの認識・読み取り | 15.6% | 61.6% | 64.4% |
出典:Anthropic公式比較表。GDPval-AA・AA-BriefcaseはElo評価で、%ではありません。Humanity’s Last Examはツールあり、OSWorldは公式表の「partial」表記、Chartographyはツールなしの数値です。※1 OpusのTerminal-Benchは最高値となるXhigh設定。※2 FrontierCodeはSonnetの設定を併記しています。設定・評価環境は各指標で異なります。
いちばん驚きやすいのは、開発作業と知的業務
Terminal-Benchでは、Sonnet 5.5の70.6%がOpus 5.5の66.4%を上回っています。差は4.2ポイントです。前世代Sonnet 5の10.3%からは60.3ポイント伸びていますが、これを「AIの知能が約7倍」と言い換えるのは不適切です。測っているのは、この評価条件での課題達成率です。
一方、GDPval-AAは1844対1846で、差はわずか2ポイント。表計算、調査、文書などの実務に関心がある方には、こちらも見逃せません。ただし、Eloの2ポイント差だけから統計的に同等と断定したり、全職種の仕事で同じ品質になると保証したりはできません。
ここから読み取れるのは、Sonnetを「品質を大きく妥協する選択肢」と決めつける理由が弱くなったことです。自社で繰り返す仕事を使い、成果物の品質を比べてみる価値があります。
画面操作やグラフの読み取りも、Opusに近づいている
OSWorldは80.1%対81.8%、Chartographyは61.6%対64.4%です。画面上の情報を読み、操作や判断につなげる能力にも進歩が見られます。
例えば、売上資料のグラフから傾向を整理し、説明文へ落とし込む作業は、比較してみたい用途です。ただし、グラフを読めることと、売上の原因を正しく特定できることは別です。「グラフから確認できる事実」と「考えられる原因」を分けて出力させると、確認しやすい成果物になります。
Anthropic自身も「複数の評価でOpusに匹敵」と説明
公式発表には、次の記述があります。
Sonnet 5.5 at Max effort even performs comparably to Opus 5.5.
複数の評価で、Max設定のSonnet 5.5がOpus 5.5に匹敵する性能を示す、という文脈です。同じ箇所で、複雑で答えが一つに決まらず、判断を続ける仕事では、Opus 5.5が明確に強いとも説明しています。
「多くの数値が近い」という驚きはそのまま受け止めつつ、任せる仕事の難しさと曖昧さを考える必要があります。公式発表のPerformance節
ベンチマークを見るときに落とせない3つの条件
1.AnthropicとArtificial Analysisのスコアを混ぜない
Terminal-Bench 4.0は、Anthropic公表値ではSonnet 5.5が70.6%。Artificial Analysisの公式投稿では、同機関の測定として64%と紹介されています。比較対象のOpus 5.5とAstraは、同投稿の丸め表示でともに60%です。
これは、別々の評価として扱います。実行環境、指示、使う道具、集計や設定が違えば、同じ名前のテストでも数値は変わります。SonnetだけAnthropicの70.6%、競合だけ別機関の60%を持ってきて差を計算するような比較は避けましょう。Anthropic・Artificial Analysis
2.Maxが、いつでも最高得点とは限らない
FrontierCodeでは、Sonnet 5.5のXhighが52.1%、Maxが46.2%。考える量を増やすと、かえって点数が下がる例です。
Anthropicの脚注によると、この評価では「人の追加修正なしでコードを取り込めるか」を見ており、依頼範囲外の変更も減点対象です。Maxではコードレビューのスキルを使う頻度が増え、調査された2件ではタイムアウトや範囲を超えた追加変更につながりました。
実務でも「たくさん調べた」「たくさん直した」だけでは成功になりません。最初に、変更してよい範囲と完了条件を伝えることが大切です。公式発表の脚注2
3.公開前モデルの不具合についても注記されている
Artificial Analysisの評価は、公開前のSonnet 5.5環境で行われました。Anthropicは、構造化出力を使うリクエストの応答を悪化させ得る不具合を見つけ、公開版では修正したと説明しています。
影響は小さい、または本来の性能を低めに示した可能性があるという説明ですが、未実施の再評価で点数が上がったことにはできません。この記事では確認できた公表値を使い、再評価前のスコアとして扱います。Artificial Analysis公式発信
安いSonnetのはずが高くなる?単価と「仕事1件の費用」を分けよう
標準APIの入力・出力単価は、Opus 5.5の半分
以下は標準API料金です。単位は100万トークン当たりの米ドルで、Claudeアプリの月額料金ではありません。
| 課金対象 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| 通常の入力 | $2 | $4 |
| 通常の出力 | $10 | $20 |
| キャッシュ書き込み・5分 | $2.50 | $5 |
| キャッシュ読み取り | $0.20 | $0.20 |
出典:Anthropic公式料金表。2026年9月29日確認。クラウド独自料金や、ツール等の追加料金は別途確認が必要です。
トークンは、AIが文章を処理する単位です。日本語の1文字と同じではありません。キャッシュは、繰り返し使う入力を再利用する仕組みで、毎回すべてを通常入力として処理する場合と費用が変わります。
例えば、通常入力1万トークン、出力2,000トークンだけを使う同条件の計算なら、Sonnetは0.04ドル、Opusは0.08ドルです。これは同じトークン数を使うという仮定での単価計算で、実際の仕事の請求額を予測したものではありません。
Max設定では、Astraよりタスク当たり費用が高い評価もある
Artificial AnalysisのIntelligence Index評価ページでは、Sonnet 5.5 Maxの費用は1タスク当たり7.60ドル、GPT-6 Astra Maxは3.26ドルと表示されています。確認日は2026年9月29日です。
この費用指標は、入力・キャッシュ・推論・回答などのトークン使用量に基づきます。Sonnetは安い単価でも、繰り返し送る入力や推論・回答が増えれば、仕事1件の費用が高くなります。これは「Sonnetが常に割高」という意味でもありません。あくまで、同評価の課題群・設定・費用計算における結果です。Sonnetの測定値・Astraの測定値
「最大30%安い」という公式説明と、矛盾するのか
AnthropicはSonnet 5との比較で、少ないトークンで仕事を進められ、同社のテストではタスク当たり費用が最大30%低くなると説明しています。一方、Artificial AnalysisのMax設定では、Sonnet 5より約50%高いという結果が報告されています。
比較している課題・推論設定・実行条件が違うため、両方を同じ条件の結果として読むことはできません。「最大30%安い」をすべての利用への保証にせず、自分が繰り返す仕事で確認しましょう。
確認したいのは、単価だけではありません。初回の成果物の品質、修正回数、完了までの時間、総使用量を同じ課題で比べると、実際に得をする選択が見えます。Anthropicの費用説明・Artificial Analysis公式発信
推論設定は5段階。Astraを超えた「Max」を常用すればよい?
Sonnet 5.5のeffortは、Low・Medium・High・Xhigh・Maxの5段階です。effortは、AIがどれだけ推論や検証に計算を使うかを調整する設定と捉えると分かりやすくなります。
Artificial Analysisが同じモデルを設定別に評価した数値を見ると、性能と費用の変化がはっきりします。
| Sonnet 5.5の設定 | Intelligence Index | 同評価のタスク当たり費用 |
|---|---|---|
| Low | 36 | $0.41 |
| Medium | 41 | $0.59 |
| High | 47 | $1.08 |
| Xhigh | 52 | $2.74 |
| Max | 56 | $7.60 |
すべて既定フォールバック有効。スコアは丸め表示。費用は同評価における加重平均であり、普段のチャット1回の料金ではありません。評価ページ
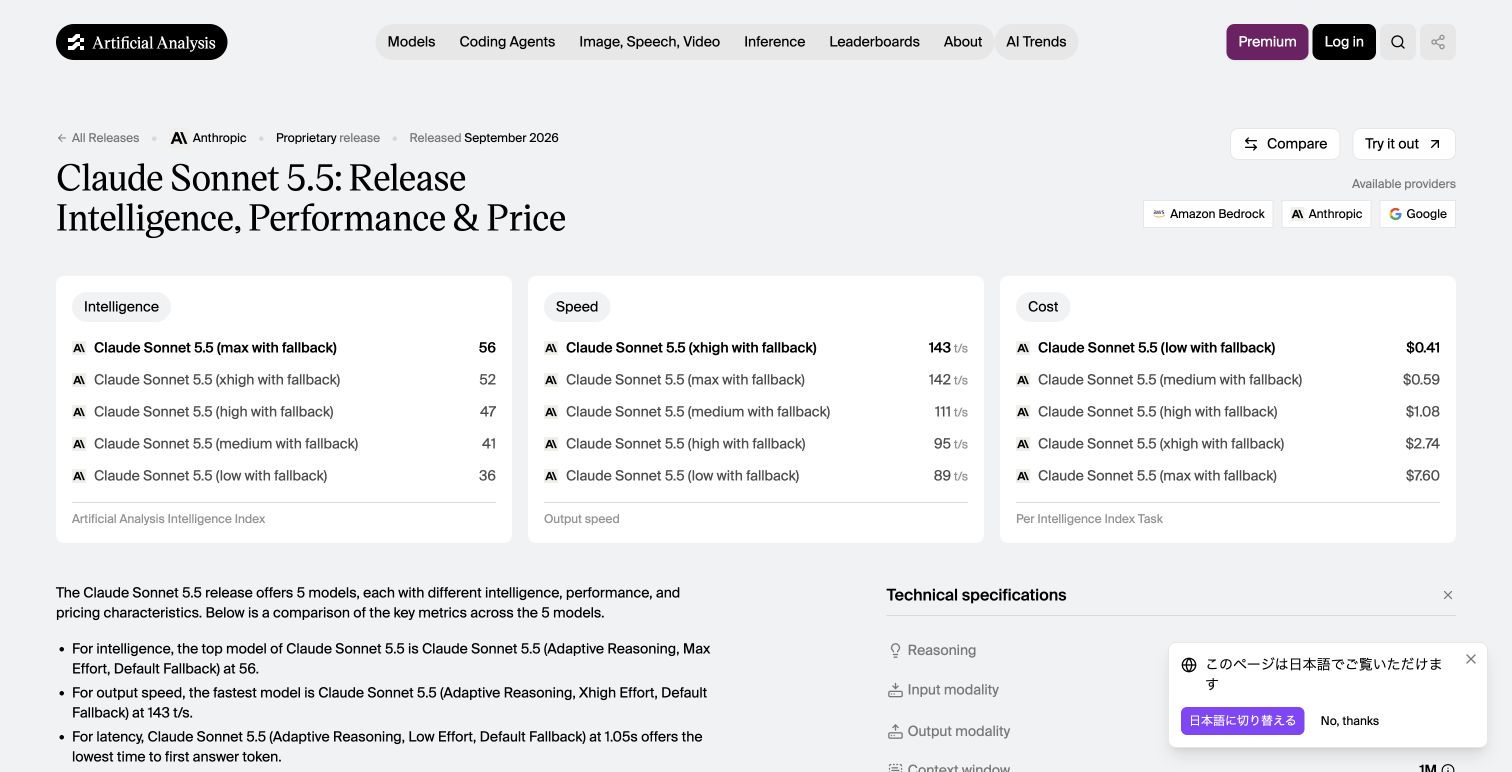
Anthropicの発表では、ClaudeアプリとClaude Codeの既定値はMedium、Claude Platformの既定値はHighです。モデルの最高性能を示すベンチマークと、何も設定を変えずに利用した場合を分けて考えましょう。
公式のeffortガイドは、明確なエージェント実装やツール作業をMediumから、難しい作業や長い工程をHighから評価する考え方を案内しています。一方、低い設定では長い作業の途中で止まったり、必要な検証が薄くなったりする可能性もあります。
節約のために必要な品質まで落とさず、その仕事の合格条件を満たす設定を、実際の成果物で選ぶのが基本です。同じ「High」という名前でもSonnet 5と5.5では調整が変わっているため、旧モデルでの感覚をそのまま移さない方がよいでしょう。公式発表・effortガイド・Sonnet 5.5プロンプトガイド
ベンチマーク以外の特徴。長い資料・画像・日常の共同作業に対応
100万トークンのコンテキストと、最大12.8万トークンの出力
APIの基本仕様は次のとおりです。
| 項目 | Sonnet 5.5の仕様 |
|---|---|
| Claude APIのモデルID | claude-sonnet-5-5 |
| コンテキストウィンドウ | 100万トークン |
| 標準の最大出力 | 128Kトークン |
| 入力 | テキスト・画像 |
| 出力 | テキスト |
| 知識の基準時点 | 2026年6月 |
出典:公式モデル仕様。利用製品や組織設定による条件は別途確認してください。
コンテキストウィンドウは、AIが一度に扱える情報の大きさです。複数の資料、長い会話、コードなどを渡す余地があります。ただし、長い資料を入れられることと、すべての細部を確実に把握できることは同じではありません。
資料を渡すときは、ファイル名、優先する資料、知りたい点、答えの根拠を示す方法まで伝えると、確認しやすくなります。モデルが持つ知識には基準時点があるため、最新のニュースや価格には別途検索・現行資料が必要です。
なお、30万トークン出力のベータもありますが、対象環境のMessage Batches API限定です。通常の同期APIで一律30万トークンを出力できる、という仕様ではありません。Batchの拡張出力
文章や資料を、やり取りしながら仕上げる用途にも注目
Anthropicは、Sonnet 5.5が前世代より明確な文章を書き、デザインや資料の仕上がりにも改善があると説明しています。公式発表で紹介された社内テストには、公開企業の決算資料と説明会の記録、スライドのテンプレートを渡し、10枚の業務レビュー資料を作らせた例もあります。
これは、すべての会社の資料が初回で完成する保証ではありません。しかし、「テンプレートを渡し、必要な情報を整理して、たたき台を作る」という試し方は具体的です。
例えば、毎月の部門会議資料なら、見出し、数字の参照元、前月との差、判断してほしい点を指定し、最後に人が数値と結論を確認する。こうした仕事で、品質と応答の速さの両方を比べられます。公式のKnowledge work節
Sonnet 5.5とOpus 5.5、仕事ではどう使い分ける?
以下は公式の位置付けと評価結果を踏まえた、当社の活用提案です。実測した導入効果ではありません。
| 仕事 | 最初に比較したい使い方 | 人が確認するポイント |
|---|---|---|
| 不具合の原因調査と修正 | Sonnetに対象・再現手順・変更範囲を渡す | 再現条件、修正の妥当性、周辺機能への影響 |
| 定型の会議資料や提案書 | Sonnetに資料とテンプレートを渡し、たたき台を作る | 数字、出典、相手に伝えたい判断事項 |
| 表計算や定型レポート | Sonnetに入力列・計算ルール・例外を明示する | 集計条件、欠損値、式、元データとの照合 |
| 承認済みFAQに基づく回答案 | Sonnetに参照資料と回答範囲を限定する | 根拠のない断定、社外へ出せない情報 |
| 要件が曖昧な大規模改修や設計判断 | Opusを含め、複雑な判断を継続できるか比較する | 代替案、長期の整合性、見落とし、総手戻り |
公式のSonnet 5.5プロンプトガイドも、最も難しい長時間の作業にはOpusがよいと説明しています。モデルの序列を一つに固定せず、作業範囲が明確か、途中の判断がどれほど難しいかで候補を絞ると実践しやすくなります。公式プロンプトガイド
また、Sonnetで作ってOpusで確認する方法も考えられますが、別のAIが確認しただけで正しさが保証されるわけではありません。数字なら再計算、コードなら実行、資料なら元の出典との照合というように、成果物に合う確認方法を用意しましょう。
使い始め方。Claude・Claude Code・APIで入口が違う
Claudeアプリで使う場合
利用中の画面でモデル選択欄を開き、Sonnet 5.5が選べるか確認します。契約プランや組織の管理設定で、表示されるモデルや利用条件が異なることがあります。
最初の比較には、すでに正解や合格条件を知っている仕事が向いています。「この議事録から担当者・期限・未決事項を整理する」「この表の差分を説明する」など、自分で品質を確かめられるものを使ってください。APIの単価とアプリの月額料金は別です。
Claude Codeで使う場合
Claude Codeでは、/modelでモデルを選び、/statusで現在の設定を確認できます。Sonnet 5.5を指定するときは、実際にそのモデルが選択されていることを確認してから比較します。公式のモデル設定案内
モデルだけ変えて、毎回別の課題を与えると比較しにくくなります。同じ不具合、同じ資料、同じ完了条件で試し、出来上がりと修正量を見てください。既存の変更を保護し、実運用のデータや本番環境を使う前に、試せる範囲を決めておきます。
APIで使う場合
モデルIDはclaude-sonnet-5-5です。公式発表ではClaude Platformに加え、Amazon Web Services、Google Cloud、Microsoft Azureでの提供が案内されています。各環境の対応リージョン・権限・機能差は、それぞれの現行資料で確認します。
Sonnet 5からの移行は、モデル名を置き換えるだけで完了するとは限りません。 特にツールを使うアプリは、次の変更を確認してください。モデル仕様・移行ガイド
開発者向け。API移行で見落としやすい変更点
初心者の方は、この章を「自社システムの担当者へ確認する項目」として読んでください。通常のClaude画面で会話するだけなら、すべてを自分で設定する必要はありません。
| 確認箇所 | Sonnet 5.5での注意点 |
|---|---|
| 思考を無効にする設定 | thinking.type: disabledはエラー。事前の思考を抑えるにはbetween_toolsへ移行する |
| ツール実行の強制 | tool_choiceのanyやtoolは非対応。autoなどを前提に設計を見直す |
| 会話と思考の履歴 | 思考ブロックはモデル・履歴・アカウントに結び付く。過去の内容を自由に書き換えて再送する設計は要確認 |
| Computer use | Claude APIとGoogle Cloudでは旧ツールから新しいtoolsetへの移行が必要。Bedrockなどとの差もある |
| 進捗表示 | 従来のテキストだけを表示する実装では、途中の処理が無言に見える場合がある |
| advisor連携 | 使える組み合わせと応答形式の変更を確認する |
出典:Sonnet 5.5の変更点、移行ガイド。
between_toolsは「思考を完全に消す」意味ではありません。ツール間の処理を含む新しいモードで、使えるeffortにも条件があります。Low・Medium・Highで利用でき、Xhigh・Maxにはadaptiveが必要です。
既存システムでは、正常時の回答だけでなく、ツールが失敗した場合、長い会話、途中からの再開、権限エラーの扱いも確認します。新モデルが高得点でも、アプリ側が応答を正しく扱えなければ、その性能を活かせません。
まず試すなら、この指示文から
以下は当社が用意した比較用の指示例です。実際のファイル名や条件へ置き換えて使ってください。成果物の品質を保証するものではありません。
資料作成:出典と判断事項を分ける
指示文を開く・閉じる
Claude Code:直す範囲と完了条件を先に決める
指示文を開く・閉じる
比較するときは、同じ資料・同じ依頼文・同じ合格条件を使います。「文章がもっともらしいか」だけでなく、数値の一致や実際の動作を見て選びましょう。
よくある疑問
Sonnet 5.5が出たら、Opus 5.5は不要?
複数のベンチマークで近い数字が出ていますが、公式は複雑で曖昧な長期作業にはOpusの強みがあると説明しています。日常的で範囲が明確な仕事ではSonnetを比較し、難しい設計・判断を続ける仕事ではOpusも候補に残す、という使い分けが考えられます。
Astraを、すべての面で上回ったという意味?
「Artificial Analysisの総合指標で、Sonnet 5.5 MaxがAstra Maxを上回った」なら、今回の確認値に沿った表現です。 すべての機能・仕事・費用でAstraを上回ったという意味には広げられません。
普段のチャットでも、1回7.60ドルかかる?
違います。7.60ドルは、Artificial Analysisが評価課題を実行した際のタスク当たり費用です。アプリの月額料金や一般的な質問1回の値段ではありません。APIも、実際の使用量やキャッシュ、ツールなどで費用が変わります。
正確さや安全性まで、すべて良くなった?
性能向上だけで無確認運用に切り替えることはできません。例えばArtificial Analysisは、事実知識を問うAA-Omniscienceの正答率をSonnet 5.5が54%、Opus 5.5が66%と報告しています。この正答率は総合指標や同評価の幻覚率とは別の指標です。評価機関の説明
Anthropicは特定の高リスクなサイバー関連要求に対して、Sonnet 5へフォールバックする仕組みを説明しています。通常の開発作業と、制限のある用途を混同しないことも大切です。公式の安全性説明
まとめ。Sonnetを「安いから妥協して使うAI」で終わらせない
Sonnet 5.5は、複数の実務系ベンチマークでOpus 5.5に迫り、Artificial Analysisの総合指標ではMax設定がAstra Maxを上回りました。Sonnetという選択肢を、品質面から見直す理由がある更新です。
同時に、Maxの高得点には大きなトークン消費が伴います。仕事に使うなら、モデル名や単価だけで決めず、同じ課題で品質・修正回数・所要時間・総使用量を比べてください。
まずは毎月作る資料、繰り返し起きる不具合、よく使う説明文などから、確認しやすい仕事を1つ選ぶ。必要な資料と合格条件を渡し、成果物を確かめる。この進め方なら、新モデルの進化を自分の業務へつなげられます。
あなたのAI顧問株式会社の「あなたのAI顧問」は、AI・DX領域のBPO × AI教育を組み合わせ、業務改善の実装と現場の自走を同時に支援する伴走型サービスです。業務の棚卸し、優先順位付け、契約範囲内での実装、現場への教育・移管までをつなぎます。
自社のどの仕事からAIを試すかを整理したい方は、AI化の優先順位について相談するからご相談ください。
関連:Claude Opus 5.5の特徴・料金・使い方/Claude CodeとGemini TTSでナレーション動画を制作した実例
WRITERライター紹介
黒山結音
あなたのAI顧問株式会社 代表取締役
「AIは現場で使えなきゃ意味がない」を掲げ、30社以上にAI顧問として導入から定着までサポート。OpenClaw・Claude・ChatGPTなどAIツールを実務でフル活用し、AI駆動経営を実践。本メディアでは、実際の現場で効果が出た事例や、AI初心者がつまずく「最初の一歩」を、専門用語を極力使わずに解説します。
OpenClaw / Claude Code / Codex / Cursor / Manus
この記事をシェアする