AIニュース
Gemini 4 Argonとは?Astra・Opusとの性能比較、100万トークン出力・料金・提供状況を徹底解説
「AIに大きな仕事を頼むと、途中で止まる。資料は読めても、最後まで仕上げてくれない」。その壁をどこまで越えられるのか。Googleの新モデル「Gemini 4 Argon」が、注目すべき数字を示しました。
Googleは2026年9月30日付で、Gemini 4 Argon(ジェミニ・フォー・アルゴン)を発表しました。目を引くのは、100万トークンへの出力上限拡大と、法律・金融・開発など、複数の工程を伴う仕事のベンチマークです。
GPT-6 AstraやClaude Opus 5.5を上回る結果もあります。ただし、すべての分野で勝っているわけではありません。そして、10月1日時点では限定提供であり、一般のGemini利用者がすぐ選べるモデルではありません。
この記事では、「何がすごいのか」「自分の仕事にどう関係するのか」「料金と使える時期はどうなっているのか」を、公式発表と評価条件に沿って整理します。
この記事でわかること
- Gemini 4 Argonの特徴と、従来の短いやり取りから変わる点
- Astra・Opusなどとのベンチマーク比較と、数字の正しい読み方
- 「100万トークン出力」が意味すること・意味しないこと
- APIの導入価格と、その期間が終わった後の価格
- 現在の提供対象と、一般提供後に試したい業務
※2026年10月1日時点の確認内容です。本記事は公式情報の解説で、当社によるArgonの実機レビューではありません。業務例は編集部の活用案であり、特定業務での効果を実測・保証するものではありません。
出典:Google公式発表
Gemini 4 Argonとは?最初に押さえたい全体像
Gemini 4 Argonは、Googleが発表した最先端のAIモデルです。公式モデルページは、実際のソフトウェア開発、企業の知的業務、サイバー防御を主要な対象として挙げています。
ここでいう「知的業務」は、資料を読み、情報を比較し、根拠を確認し、判断に使える成果物にまとめる仕事です。営業企画の調査、財務資料の分析、契約文書の検討などをイメージすると分かりやすいでしょう。
「質問に答える」より長い仕事では、途中で新しい情報が見つかったり、最初の仮説を修正したりする必要があります。その間も目的と制約を保って進められるかが、実用上の大きな違いになります。
| 項目 | 発表内容・確認状況 |
|---|---|
| 正式な発表名 | Gemini 4 Argon |
| 公式発表日 | 2026年9月30日付 |
| 主な対象 | 開発、企業の知的業務、サイバー防御 |
| 注目する仕様 | 出力上限を従来の64Kから1Mトークンへ拡大 |
| 現在の提供 | Fairwind Programの一部パートナーなどへの限定提供 |
| 今後の一般展開 | 有料API利用者とGoogle AI Ultra契約者から開始する方針 |
| 一般向けの開始日 | 確認した公式発表には具体的な日付の記載なし |
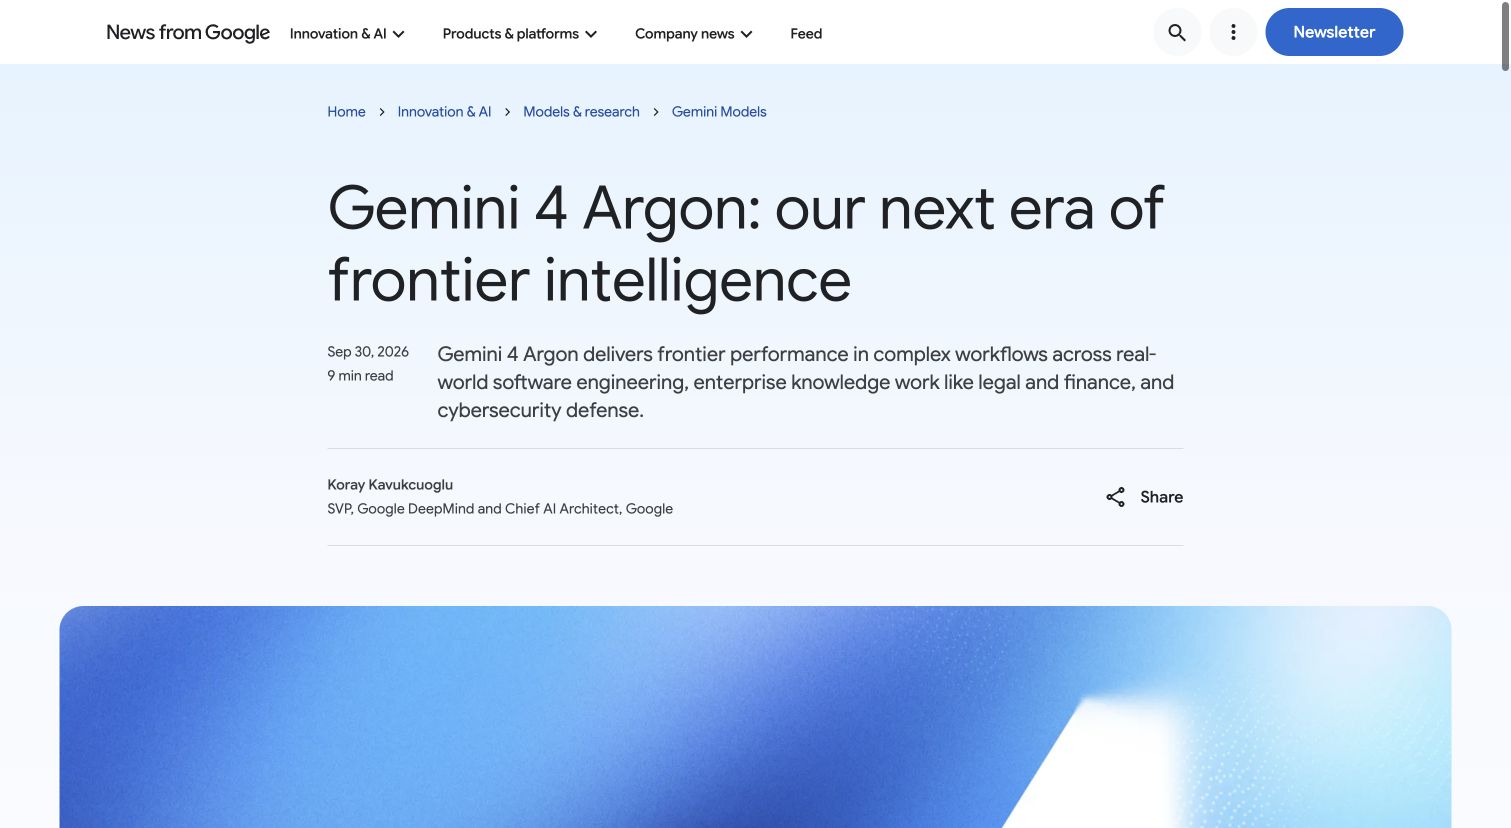
なお、Geminiのモデル名、Geminiアプリの機能、利用プランは別々に確認する必要があります。新モデルの発表があっても、手元のアプリが自動的にそのモデルへ切り替わったとは限りません。
出典:Google DeepMindのモデルページ、Google公式発表
何がすごい?仕事に関係する4つの特徴
1.長い開発作業を進める能力
開発の仕事には、「関数を1つ書く」だけでなく、既存コードを調べる、原因を特定する、修正する、テストする、別の箇所への影響を確認する、といった連続した工程があります。
Argonは、長いソフトウェア開発タスクを測るDeepSWE v1.1で77.9%を記録しています。Googleの比較表にあるAstraの74.1%、Opus 5.5の74.2%より高い数値です。一方、別の開発評価では順位が入れ替わります。詳しくは次の比較表で確認します。
利用者にとっての期待は、コードの最初の案を作る力に加えて、検証と修正を重ねて完成へ近づける力です。社内ツールの改修なら、画面が動くだけでなく、元の業務が正しく処理されるところまで評価したい部分です。
2.法律・金融など、資料と根拠を扱う仕事
Argonは、Vals Indexや金融・法律分野の評価でも、公式比較表の中で高い数値を示しました。Vals Indexは、複数の専門業務をまとめて見るための指標で、業務の構成や重み付けが定められています。
ただし、こうした指標は「会社の仕事の何割を任せられるか」をそのまま示すものではありません。たとえば契約書なら、条項を発見できるか、関連資料と矛盾していないか、根拠の所在を示せるか、といった工程ごとに確認が必要です。
編集部が注目するのは、複数の資料をつないで、判断のための下準備をどこまで進められるかという点です。最終判断に必要な前提や未確認事項を残せるかまで含めて、実務で試す価値があります。
出典:Vals Indexの評価元による説明、Google公式比較表
3.図表や長い動画を含む情報の理解
文章だけでなく、画像など複数の形式を扱う能力を「マルチモーダル」と呼びます。Argonは図表理解のChartographyで71.6%、長い動画理解のLVBenchで91.7%という数値を示しています。
仕事の資料は、文章だけできれいに完結しません。説明文はPDF、数値はグラフ、操作手順は動画、補足は議事録というように分かれていることがあります。それらを照合できれば、文章化する前の情報整理にも役立つ可能性があります。
ただし、動画を理解する性能と、ナレーションや映像を生成する機能は別です。 今回の発表から、Argon単体で動画生成や音声合成までできると広げて解釈することはできません。音声制作の具体例は、当メディアのGemini 3.8 Flash TTSの記事で紹介しています。
また、LVBenchはモデルごとに与えたフレーム数が異なります。高いスコアは注目点ですが、完全に同じ映像入力条件での比較ではないことも押さえておきましょう。
4.脆弱性の発見から修正までを支援するサイバー防御
サイバー防御では、ソフトウェアの弱点を見つけ、その弱点が実際に問題を起こすか検証し、修正につなげる能力が焦点です。
GoogleのFairwind Programでは、政府機関や重要インフラを担う組織など、審査を通過した防御側のパートナーに先行アクセスを提供しています。Argonは一部のパートナー向けに提供され、ソフトウェアの修正を支援するCodeMenderと組み合わせることも案内されています。
これは、誰でも申請すれば即座に利用できる一般向けの先行登録とは異なります。用途、組織の適格性、アクセス管理などに条件があります。
Astra・Opus超え?公式ベンチマークを比較する
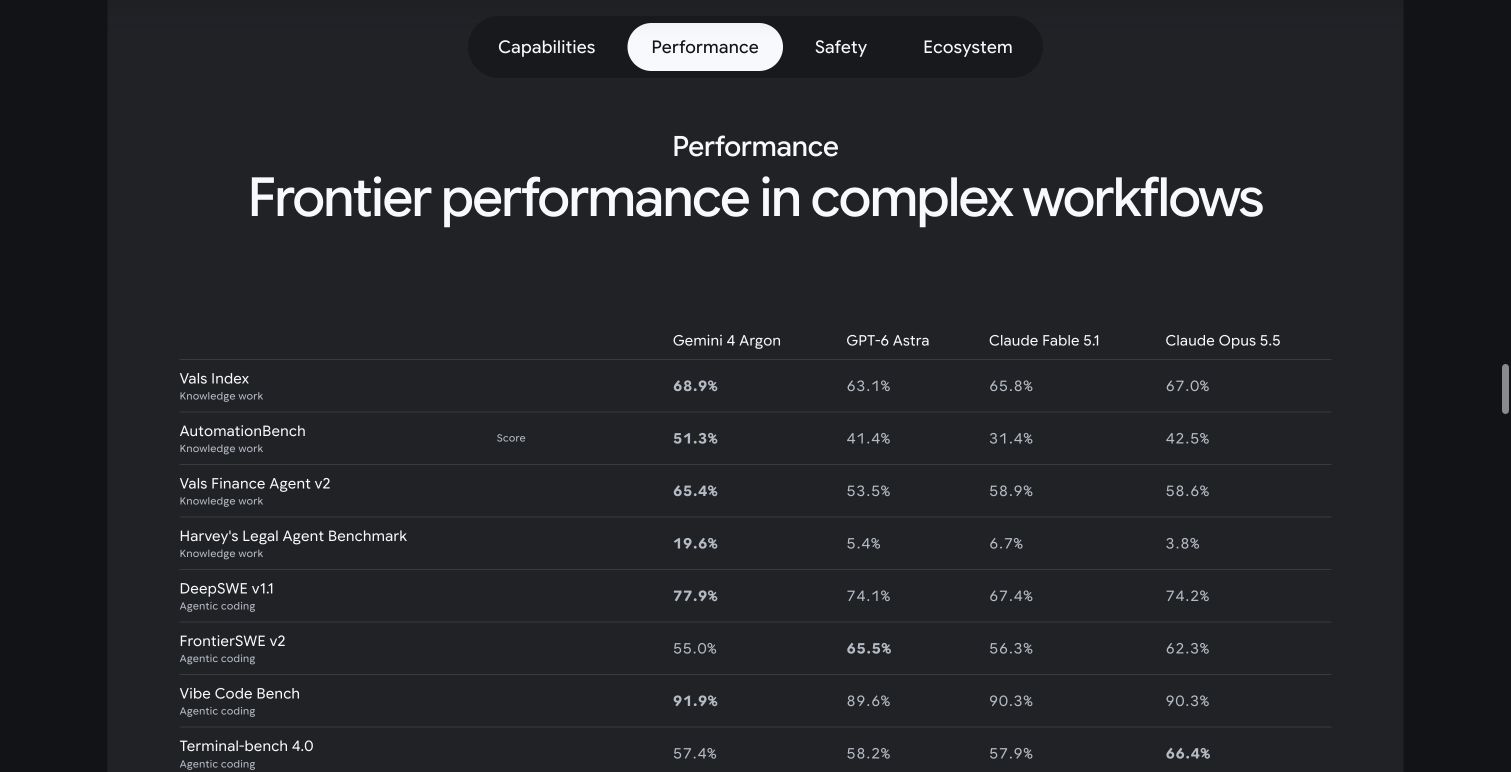
Googleの掲載表をベンチマーク名単位で数えると、18種のうち12種でArgonが単独最高、1種で同率最高です。 残る5種では他モデルが上回ります。
これは、表に掲載された比較対象の中での集計です。全AIモデルの世界順位や、すべての仕事における優劣を意味しません。GraphWalksには2つの入力長条件があるため、表の評価行は19行あります。
知的業務・開発で目立つ数値
数値はGoogle公式表の掲載値です。太字は、この表の各行で最も高い値を示しています。
| 評価項目 | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% |
| Harvey’s Legal Agent Benchmark | 19.6% | 5.4% | 6.7% | 3.8% |
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
| PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% |
ArgonはAutomationBenchでAstraを9.9ポイント、Vals Finance Agent v2では11.9ポイント上回ります。いずれも掲載値の差であり、「仕事が9.9%速くなる」「売上が11.9%増える」という意味ではありません。
Harveyの法律分野の数値は差が大きく見えますが、Argon自身も19.6%です。特定の難しい評価でのスコアを、法律相談全般の正答率や、専門家を代替できる割合として読むことはできません。
開発でも、DeepSWEはArgonが高い一方、FrontierSWEではAstra、Terminal-Bench 4.0ではOpus 5.5が高くなっています。「開発なら必ずこのモデル」と決めるより、実際に任せたい作業に近い評価を見るのが有効です。
科学・長文・画面操作・マルチモーダルの結果
| 評価項目・条件 | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% |
| LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% |
| RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% |
| GraphWalks:128K以下、BFS・F1 | 99.7% | 98.7% | 91.4% | 90.6% |
| GraphWalks:256K〜1M、BFS・F1 | 84.2% | 71.8% | 65.0% | 66.8% |
| Agent’s Last Exam:pass rate | 39.5% | 34.2% | — | 38.2% |
| OSWorld-2.0:offline subset・partial score | 69.2% | 72.6% | — | — |
| Chartography | 71.6% | 71.0% | 46.2% | 66.3% |
| LVBench | 91.7% | 87.5% | 79.7% | 83.7% |
| CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% |
「—」は値が掲載されていないことを示し、0点ではありません。CWE-bench v1は、掲載表ではArgonとAstraが同率です。GraphWalksは長い入力の中の関係を追う評価であり、後述する「100万トークン出力」の測定ではありません。
出典:Google DeepMind公式比較表。数値の差と最高値の件数は同表を基に編集部で計算。
比較表を見るときに外せない3つの条件
公式の評価方法まで読むと、ランキングの見え方が変わる部分があります。
1つ目は、評価の出所と実行環境です。 競合の自己報告値、公開ランキング、Googleによる再測定が混在しています。すべての値が、同一環境・同一費用で測られたわけではありません。原則として高い推論設定を用いており、普段の軽い設定で同じ結果になるとも限りません。
2つ目は、動画に与えた情報量です。 LVBenchでは、Geminiは毎秒1フレーム、Astraは800フレーム、Fableは300フレーム、Opusは600フレームという条件です。これはAPIの制約に合わせた違いで、「同じ枚数の画像で競争した」とは説明できません。
3つ目は、評価の一部を使った数値があることです。 OSWorld-2.0はオフライン部分の部分点で、Argonは3回の評価の最大値です。Claude側に同条件の値がないため空欄になっています。通常のOSWorldの別バージョンや、全体の成功率と混ぜないようにしましょう。
これらはArgonの結果を否定する話ではありません。数字が測った範囲を理解すると、自分の用途で確かめるべき点が明確になるということです。
「100万トークン出力」は何を変える?
今回の仕様で特に目立つのが、出力上限の拡大です。公式発表には、次の記載があります。
“output token limit to an industry-leading 1M tokens”
出典:Google公式発表。出力トークンの上限を100万へ拡大するという説明です。
トークンは、AIが文章やコードなどを処理するときの単位です。日本語の「文字数」と同じではなく、文章の内容やモデルの処理方法で対応が変わります。
| 混同しやすい言葉 | 意味 |
|---|---|
| 入力 | AIへ渡す質問、資料、コードなど |
| 出力 | AIが推論・生成を進める側のトークン。画面に見える最終回答と同一とは限らない |
| コンテキスト | 処理の際に参照する情報の範囲。具体的な上限や入力・出力の扱いはモデルの仕様で確認する |
今回は「出力上限が1M」という発表です。「100万文字の日本語を必ず一度に返す」「どんな量の資料でも入力できる」「無料で100万トークン使える」という意味ではありません。
従来の64Kからの拡大は、複雑な仕事の途中で推論や生成に使える余地を広げるものと理解できます。たとえば大きなコード修正では、最初の案を出してから、エラーを確認し、別の案を試し、テストを直すことがあります。その連続した処理を進めるための余裕が注目点です。
一方、上限が大きいほど、毎回上限まで使うべきというわけではありません。 短いメールの修正と、大規模なコード移行では必要な処理が違います。実際の利用では、完成の条件、予算、途中で確認したい箇所を設定し、品質と総コストを見ながら使い分けることになります。
なお、一般向けAPIの入力上限、モデルID、利用回数や速度の制限などは、提供開始時の個別ドキュメントで確認が必要です。今回の発表だけから推測して設定値を書くことはできません。
料金はいくら?導入価格と、その後の価格を分けて確認
GoogleはAPIの予定単価を発表しています。「入力2ドル・出力10ドル」は導入期間の価格で、期間終了後の価格も注記されています。
| APIの課金対象 | 導入期間 | 導入期間終了後 |
|---|---|---|
| 通常の入力:100万トークン当たり | 2米ドル | 4米ドル |
| 出力:100万トークン当たり | 10米ドル | 20米ドル |
導入期間の終了日は、確認した発表には明記されていません。キャッシュされた入力については、入力価格から95%割引と案内されています。導入価格の2ドルを基に計算すると、該当する入力100万トークン分は0.10ドルです。キャッシュが使われる条件や、保存料金などを含む最終的な課金仕様は、利用するサービスのドキュメントで確認してください。
具体的な計算例
仮に、キャッシュなしの入力10万トークンと、課金対象となる出力2万トークンを使った場合、上記単価だけで計算すると次のようになります。
- 導入期間:入力0.20ドル+出力0.20ドル=0.40ドル
- 導入期間終了後:入力0.40ドル+出力0.40ドル=0.80ドル
これは計算方法を示す例で、特定の仕事に必要なトークン量の実測ではありません。税、外部ツール、実行環境などの費用は含めていません。
また、APIの従量料金とGoogle AI Ultraの月額料金は別のものです。API単価を、そのままGeminiアプリで1回質問する料金として読むことはできません。
料金を比較するときは、100万トークン当たりの単価に加えて、1つの仕事を終えるまでの総使用量、再試行、待ち時間、人による修正時間を見ます。安い単価でもやり直しが多いと総費用が増え、高い単価でも少ない試行で終わるなら選ぶ価値が出てきます。
出典:Google公式発表と「More Information」の料金注記、Gemini API料金ページ
もう使える?日本での利用と一般公開の予定
2026年10月1日時点では、一般公開済みとは案内されていません。 まずは信頼されたサイバー防御パートナーなどへの限定提供が始まっています。
一般展開の入口について、Googleは次のように説明しています。
“starting with paid API customers and Google AI Ultra subscribers.”
有料API利用者とGoogle AI Ultra契約者から始める方針です。ただし、この文は「今すぐUltraに入ればArgonを使える」という説明ではありません。
| 利用者・利用経路 | 10月1日時点で確認できること |
|---|---|
| Fairwind Programの一部パートナー | 限定アクセスの対象。審査・用途・アクセス管理などの条件あり |
| 有料API利用者 | 一般展開の最初の対象として予告。具体的な開始日は未記載 |
| Google AI Ultra契約者 | 一般展開の最初の対象として予告。契約だけで即利用できるとは未確認 |
| Google AI Pro・無料利用者 | 今回の発表では具体的な提供時期を確認できず |
| 日本の一般利用者 | 日本向けの開始日や詳細条件は確認できず |
日本で利用したい場合も、発表日だけで判断せず、公式の提供対象と、自分のアカウントのモデル選択画面を確認する必要があります。Argonのためだけにプランを変更する場合は、実際に対象となっているかが分かってから判断するのが確実です。
出典:Google公式発表「Rolling out soon」、Fairwind Program
Google社内では何に使われている?大きな数字の読み方
Googleは、Argonを社内業務で利用している事例も紹介しています。
| 発表された事例 | 数字を読むときの注意 |
|---|---|
| データセンターのメモリ最適化 | 適用後に300TiB超を解放したと説明。総削減500TiB〜1PiBは見積もりとして区別されている |
| C/C++からRustへの大規模なコード移行 | Fuchsia OSのZirconカーネルでは80万行超の規模に言及。移行作業中であり、本番反映前の監査・テスト・レビューを伴う |
| 動画デコーダーlibgav1の最適化 | 既存のRust移植版に対して2.7倍高速化したと説明。元の最適化済みC++版に対して2.7倍という意味ではない |
TiBはデータ量の単位で、1TiBは1,024GiBです。ただし、大規模なデータセンター全体の改善幅を、自社のサーバーにそのまま当てはめることはできません。
ここから得られる実務上の示唆は、実際の測定データを与え、改善を試し、結果を検証する仕事が対象になっていることです。「速くして」と頼むだけでなく、どの処理が遅いか、変更前の結果は何か、何を満たせば成功かを用意するほど、改善の良し悪しを判断しやすくなります。
一般提供後、どんな仕事から試すとよい?
ここからは公式の導入実績ではなく、発表された能力を踏まえた編集部の活用案です。最初は、結果を確認しやすく、現在のやり方と比較できる仕事を選ぶと評価しやすくなります。
| 担当する仕事 | 試す題材の例 | 人が確認する点 |
|---|---|---|
| 企画・営業 | 複数資料から顧客の課題と提案の論点を整理 | 根拠の所在、顧客固有の事情、未確認情報 |
| 経理・経営企画 | 月次資料の差異を調べ、説明文の下書きを作成 | 集計条件、元の数値、推測と事実の区別 |
| 法務・管理部門 | 契約書と社内基準を照合し、検討箇所を抽出 | 適用するルール、重要条項、専門家による判断 |
| 開発・情報システム | 小さな改修を、調査から修正・テストまで依頼 | 既存機能への影響、テスト結果、変更範囲 |
| 教育・制作 | 許可された解説動画と資料を照合して教材案を作成 | 参照箇所、説明の正確さ、利用権限 |
「いい感じ」ではなく、完成の条件を伝える
長い仕事を任せるときは、依頼を次の5点に分けると、成果物を評価しやすくなります。
- 目的:誰が、どんな判断や作業に使うのか
- 材料:使ってよい資料と、参照すべき版・日付
- 完成形:比較表、修正したコード、報告書などの形式
- 制約:予算、期限、変更してよい範囲、確認が必要な操作
- 検証:数値の照合、根拠リンク、テスト、未確認事項の一覧
たとえば「営業資料を改善して」より、「この顧客への提案に使う。承認済み料金表と議事録を根拠に、3案を比較し、未確認の条件は別欄に残す」と依頼した方が、期待する仕事を明確にできます。
比べるのは、成果物の品質と総作業時間
モデルを試す際は、同じ資料と同じ依頼で、現在使っているAIとも比較します。出力の見栄えだけでなく、誤り、確認漏れ、手直し、総費用を記録してください。
おすすめは、AIが作業した時間と、人が確認・修正した時間を分けて測ることです。AIの出力が速くても、確認に倍の時間がかかれば、業務全体では改善していない可能性があります。逆に、少し待っても、根拠と成果物が整っていれば価値があります。
よくある疑問
Gemini 4 Argonは、GPT-6 Astraより高性能ですか?
Google公式表では、知的業務や長文・動画理解などで上回る数値があります。一方、FrontierSWE v2、Terminal-Bench Science 0.1、OSWorld-2.0の掲載条件ではAstraが上です。用途と測定条件をそろえて判断する必要があります。
Claude Sonnet 5.5より強いですか?
今回のGoogle公式表の比較対象は、Astra、Fable 5.1、Opus 5.5です。Sonnet 5.5の同条件の値は掲載されていないため、この表だけで直接比較はできません。Sonnetの別評価については、Sonnet 5.5の解説記事をご覧ください。
「100万トークン」は、入力できる資料の量ですか?
今回の注目仕様は出力上限です。GraphWalksの長い入力に関する評価とは別です。商用APIの入力上限を確認した情報として流用することはできません。
Google AI Ultraに加入すれば、今すぐ使えますか?
公式発表では今後の一般展開の対象として予告されていますが、10月1日時点で加入直後の利用を保証する案内は確認できません。実際の対象条件が明らかになってから確認してください。
出力が長いほど、よい回答になりますか?
長く生成できることと、内容が正しいことは別です。長い処理が必要な仕事では余裕が役立ちますが、短い仕事で長文を出し続ける必要はありません。必要な成果物と検証方法を先に決めることが大切です。
Gemini 4 Argonで注目したいのは「長い仕事をどこまで任せられるか」
Gemini 4 Argonは、専門業務と長い工程を持つ仕事で注目すべき結果を示しました。100万トークンへの出力上限拡大も、その方向性を表しています。
導入を考えるうえでは、現在は限定提供であること、料金には導入期間があること、ベンチマークの順位は用途によって変わることを押さえておきたいところです。一般提供後は、自社の実際の資料と仕事で、確認や修正を含めた成果を比べることが次の一歩になります。
あなたのAI顧問株式会社は、AI・DX領域のBPO × AI教育を通じて、業務の棚卸し、優先順位付け、実装・自動化、現場教育、運用の定着までを支援しています。新しいAIを自社のどの業務に使うか整理したい方は、お問い合わせフォームからご相談ください。
※本記事はGoogleなどの公式発表・評価資料をもとに作成しました。機能、料金、利用対象は変更される場合があります。各節に記載した公式リンクから最新条件をご確認ください。
WRITERライター紹介
黒山結音
あなたのAI顧問株式会社 代表取締役
「AIは現場で使えなきゃ意味がない」を掲げ、30社以上にAI顧問として導入から定着までサポート。OpenClaw・Claude・ChatGPTなどAIツールを実務でフル活用し、AI駆動経営を実践。本メディアでは、実際の現場で効果が出た事例や、AI初心者がつまずく「最初の一歩」を、専門用語を極力使わずに解説します。
OpenClaw / Claude Code / Codex / Cursor / Manus
この記事をシェアする