AIナレッジ
生成AIのセキュリティ対策|業務利用で決めるべき7つの設定基準
生成AIの業務利用について、「禁止」か「野放し」かの二択で判断が止まっている企業は少なくありません。生成AIのセキュリティで要になるのは、データ範囲や権限など7つの設定項目を1つずつ決め切ることです。本記事では、7項目それぞれで何を基準に判断するかを、サービスの契約形態ごとの違いとあわせて整理します。
生成AIのセキュリティは「禁止」でなく「設定」で管理する
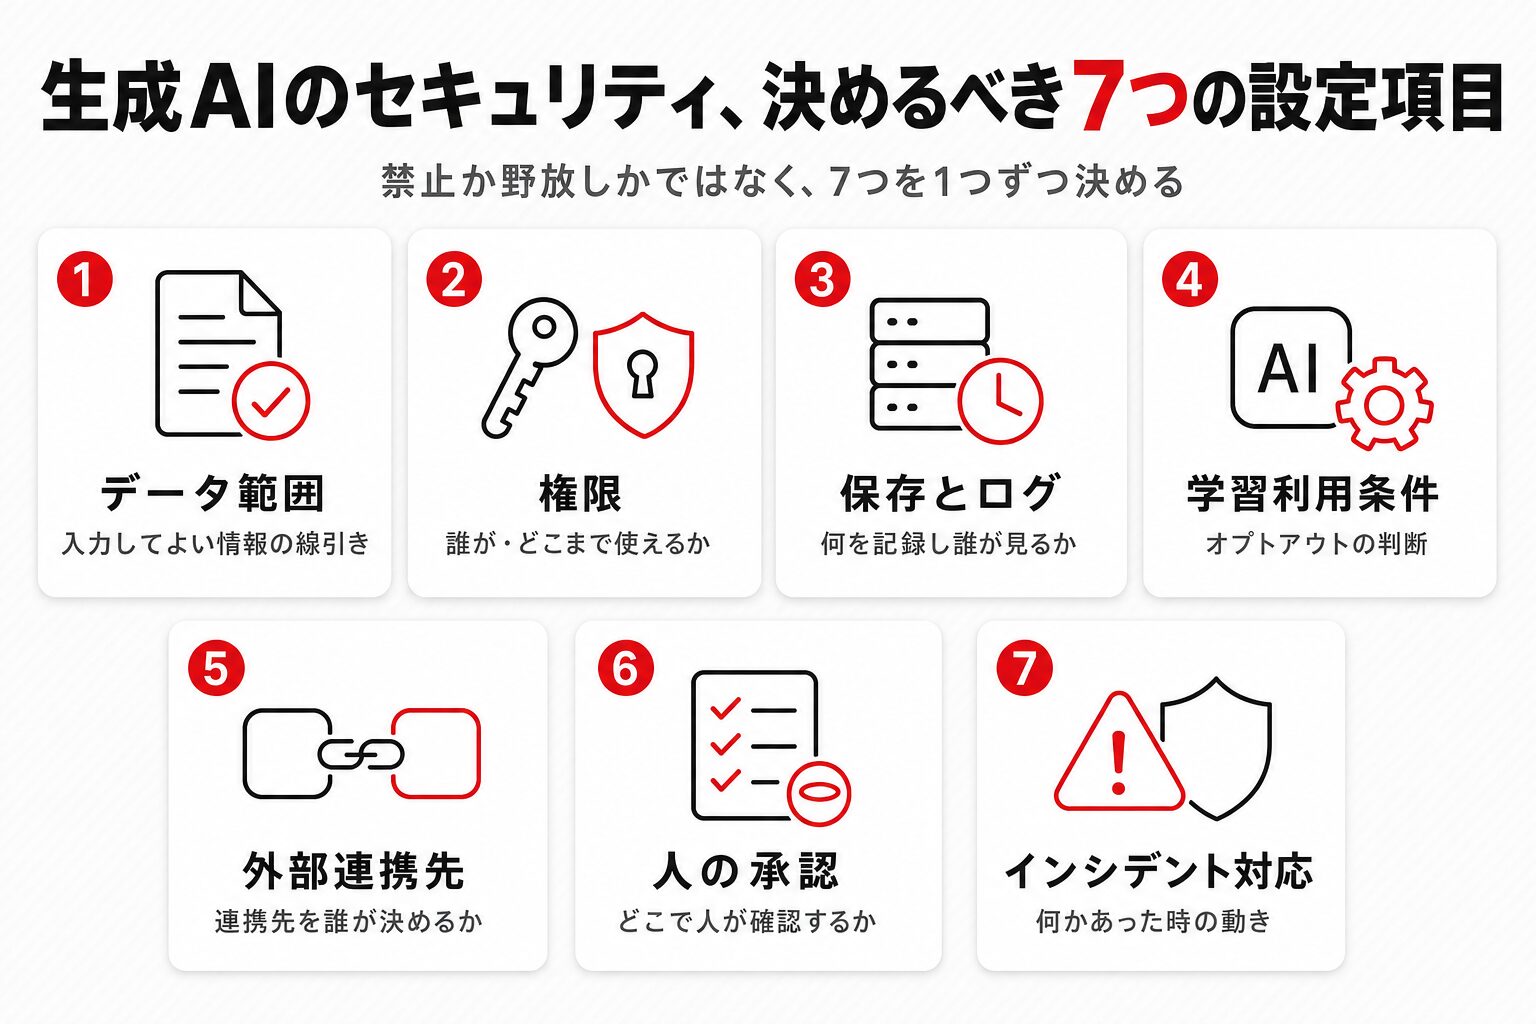
この二択で考えているかぎり、社内の判断はいつまでも定まりません。実際に管理すべきは、使う・使わないの二択ではなく、データ範囲・権限・保存とログ・学習利用条件・外部連携先・人の承認・インシデント対応という7つの設定項目です。
本記事では、この7項目を1つずつ、どのサービス・契約形態で何が担保できるかという判断基準とともに解説します。
一律禁止では追いつかない、というのが実態
日本企業を対象とした調査では、自社の何らかの業務で生成AIを利用していると回答した割合が86.4%に達し、2024年度調査から大幅に上昇しました。一方で、生成AIの活用に「組織的な取組はない」と回答した割合は27.0%に上り、米国・ドイツ・中国に比べて顕著に高い結果です。
現場では既に使われているのに、社内のルールが追いついていない状態がうかがえます。
出典:総務省「令和8年版情報通信白書」生成AIの業務利用状況
「決める」対象は7つに整理できる
生成AIのセキュリティで決めるべきことは、データ範囲・権限・保存とログ・学習利用条件・外部連携先・人の承認・インシデント対応の7項目です。どの項目も「使ってよい・悪い」の一言では済みません。ガイドラインとして運用に落とし込む判断基準がそろって、はじめて現場で機能します。
当社でも、従業員とAIエージェントで日々の業務を回すにあたり、最初に取り組んだのが「何を・どこまで」の線引きでした。
なぜ生成AI特有の脅威に備える必要があるか
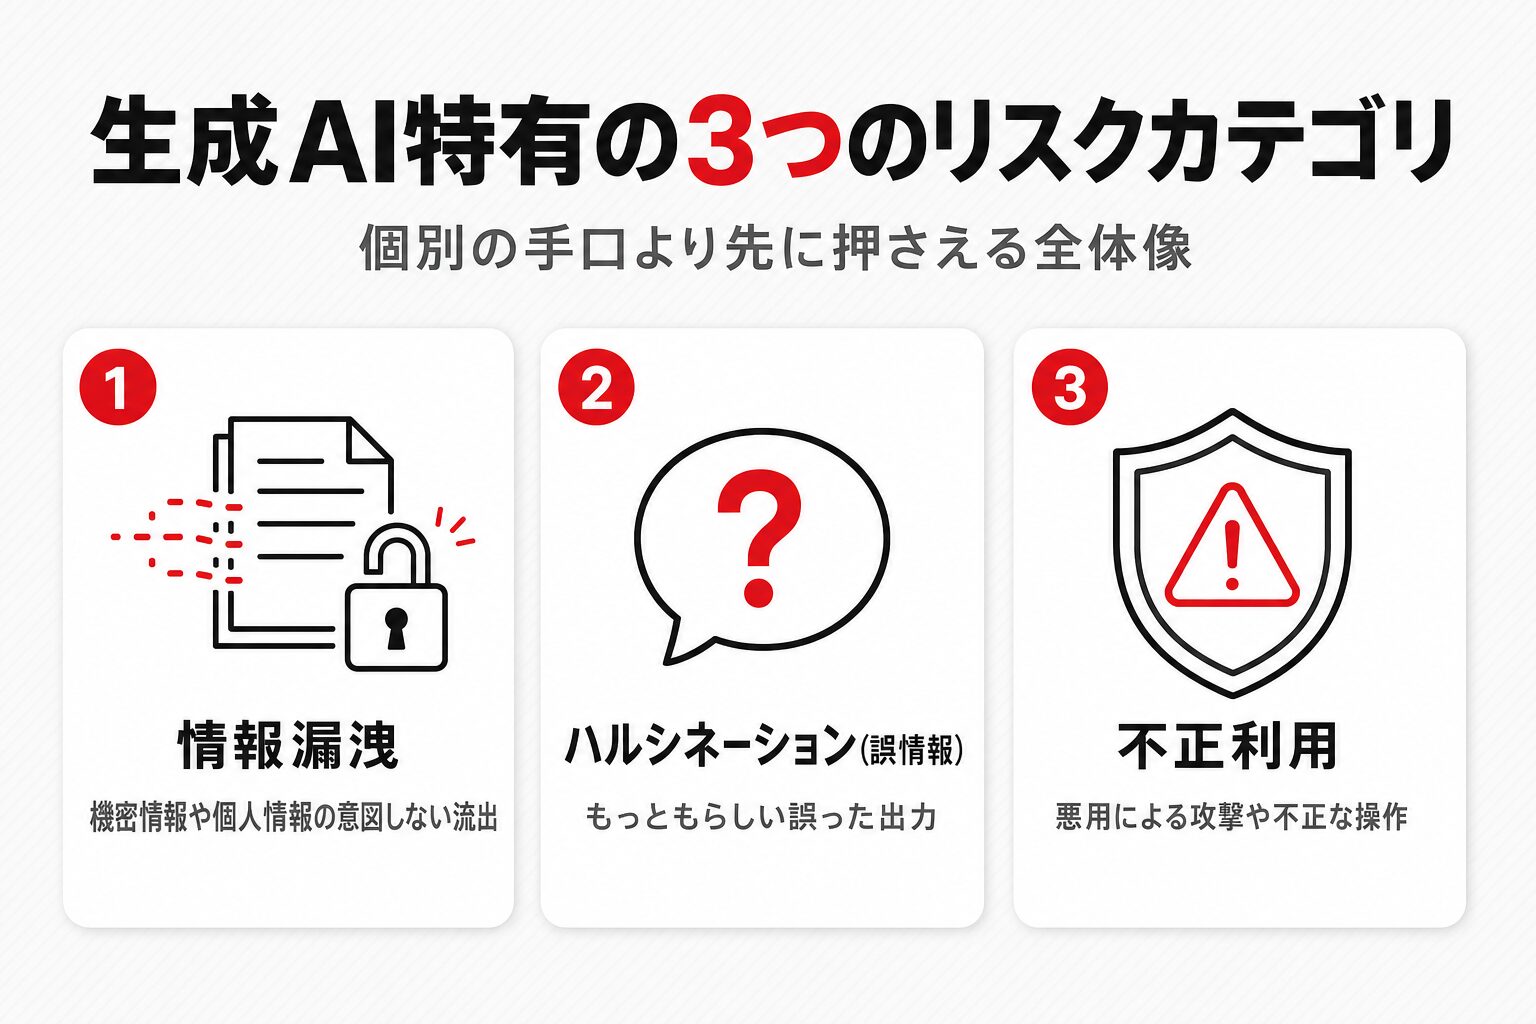
生成AIの業務利用が広がるにつれて、情報漏洩・誤情報の出力・悪用による攻撃という3つのカテゴリで、従来のITツールにはなかった脅威への備えが必要になっています。個別の攻撃手口を細かく知るよりも先に、なぜ「設定」で備える必要があるのかという根拠を押さえることが先決です。
ここでは、公的機関がどう位置づけているかを確認します。
情報セキュリティ10大脅威にも入った公的な位置づけ
IPAの「情報セキュリティ10大脅威2026」では、組織向け脅威の第3位に「AIの利用をめぐるサイバーリスク」が選ばれました。この項目は2026年に初めて選出されたもので、情報セキュリティの専門家や実務担当者による選考会の審議を経て決定されています。
生成AIのリスクは、一部の専門家だけが注意する話ではなく、公的機関が組織向けの主要な脅威として扱う段階に入っています。
個人情報保護法・AI事業者ガイドラインが利用者に求めていること
AI事業者ガイドライン第1.2版は、AI利用者に機密情報の不適切な入力を避け、AI提供者のセキュリティ留意点を守るよう求めています。個人情報保護委員会も、個人情報を含むプロンプトの入力は利用目的の範囲内かを十分に確認するよう注意喚起しています。
令和8年成立の改正個人情報保護法は、2026年9月時点でまだ施行されておらず、政令・規則の整備が進んでいる段階です。
出典:総務省・経済産業省「AI事業者ガイドライン(第1.2版)」
出典:個人情報保護委員会「生成AIサービスの利用に関する注意喚起等について」
当社は公的な指針をどう扱っているか
当社は従業員5名とAIエージェントで日々の業務を回しており、業務データがAIに触れる場面が毎日あります。公的な指針を読み物として置いておかず、7つの設定項目に翻訳して自社の運用へ落とし込むのが、当社の扱い方です。
指針の改定があったときにどの設定項目を見直すかまで、あらかじめ決めてあります。
個別の脅威を深く知りたい人はこちら
プロンプトインジェクションなど個別の脅威の具体的な内容は、【必須】あなたの情報、AIにダダ漏れかも?いますぐできる情報漏洩&AIの嘘対策マニュアルで個人の心得として解説しています。
ChatGPTに限定した具体的なセキュリティ対策は、【2025年最新版】ChatGPTで情報漏洩?中小企業が知るべき生成AIセキュリティ対策ガイドにまとめています。
設定①データ範囲:入力してよい情報・ダメな情報をどう線引きするか
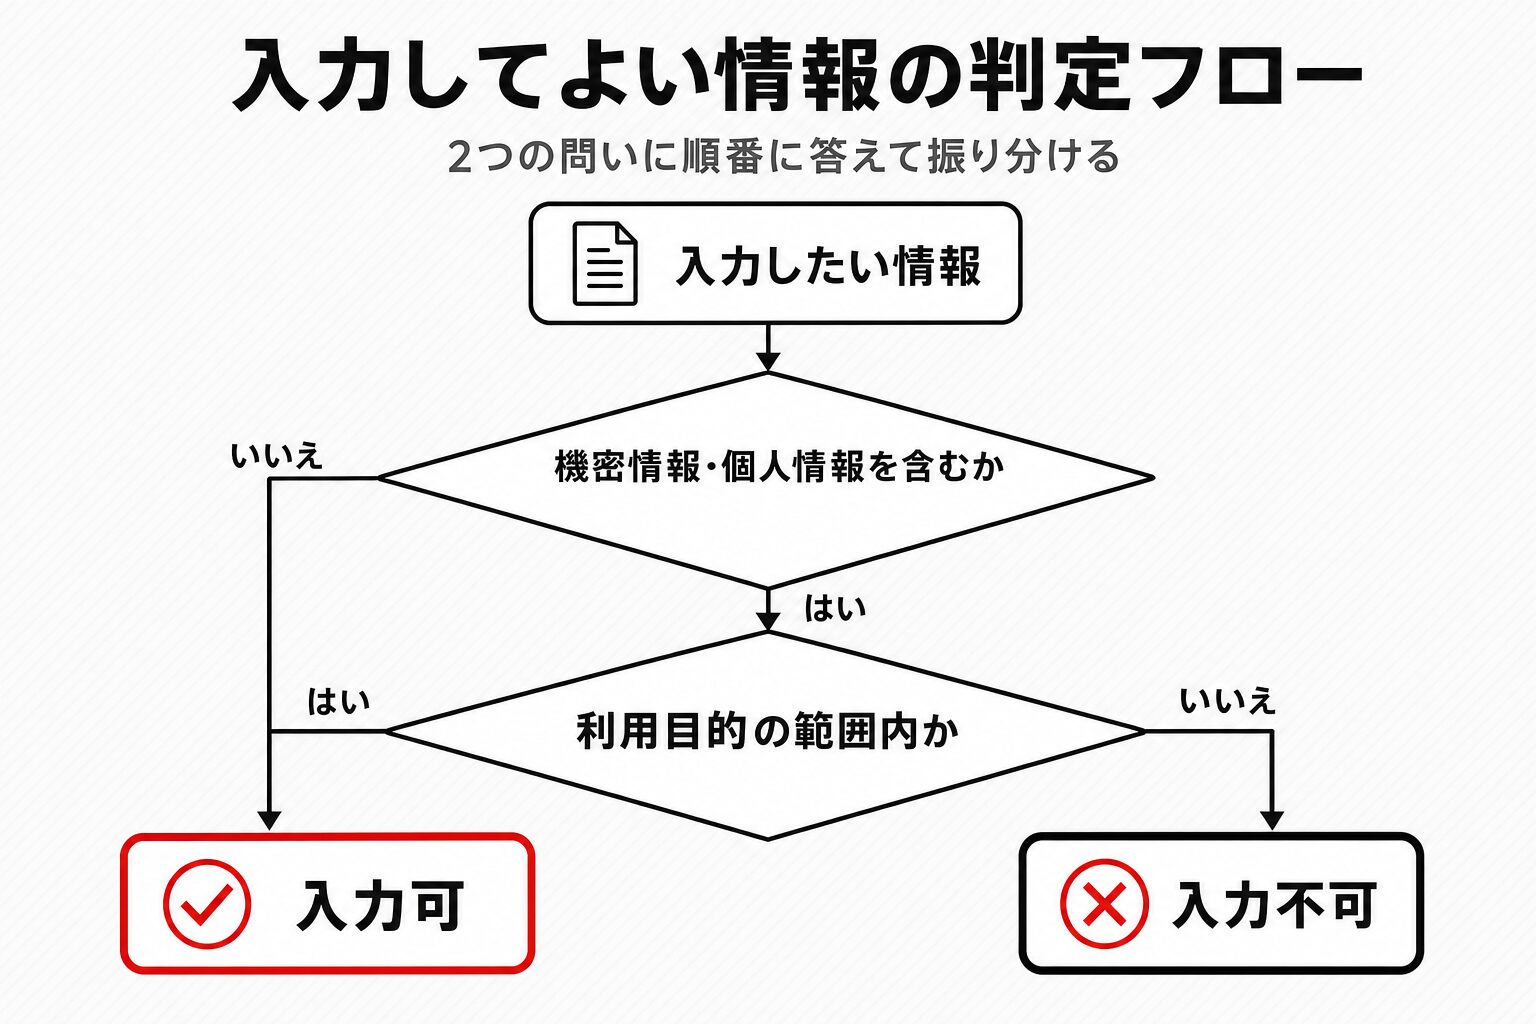
生成AIのセキュリティで最初に決めるべきは、どこまでの情報を入力してよいかという範囲です。機密情報や個人情報を無自覚に入力してしまうと、情報漏洩や個人情報保護法違反につながりかねません。
まず押さえるのは、業務データの入力可否を判断する基準と、契約形態による扱われ方の違いです。
判断基準は「利用目的の範囲内か」だけでよい
個人情報保護委員会は、個人情報を含むプロンプトを入力する場合、特定された利用目的を達成するために必要な範囲内であるかを十分に確認するよう求めています。この一文をチェックリストの形にして、入力前に照合する運用にすれば、迷ったときの判断が現場で止まりません。
業務に無関係な個人情報を興味本位で入力しない、という原則も同時に守るべき点です。
出典:個人情報保護委員会「生成AIサービスの利用に関する注意喚起等について」
契約形態によって、そもそも入力データの扱われ方が違う
生成AIサービスは、個人向けプランと商用向けプラン(Business・Enterprise・API等)で、入力データの扱われ方の既定値が異なります。商用向けは主要サービスとも既定で学習に使われない設計が一般的ですが、個人向けは契約や設定によって扱いが変わるため、料金の有無だけで安全性を判断できません。
契約形態ごとの具体的な条件は、後述する学習利用の章のとおりです。
出典:OpenAI「Enterprise privacy at OpenAI」
出典:Google Workspace「Generative AI in Google Workspace Privacy Hub」
出典:Microsoft Learn「Data, Privacy, and Security for Microsoft Copilot」
出典:Anthropic Privacy Center「Is my data used for model training?」(商用向け)
当社ではどう線引きしているか
当社では、経理や日程調整など役割ごとに担当するAIエージェントを分けており、それぞれが扱ってよい業務データの範囲も役割単位で区分しています。秘書的な役割のエージェントには日常的な情報共有の範囲まで、経営管理を担うエージェントには数値管理に関わる情報までと、扱う範囲を分けて運用する考え方です。
全社一律の1つのルールにせず、役割ごとに線を引くことを優先しました。
設定②権限:誰が・どのツールを・どこまで使えるようにするか
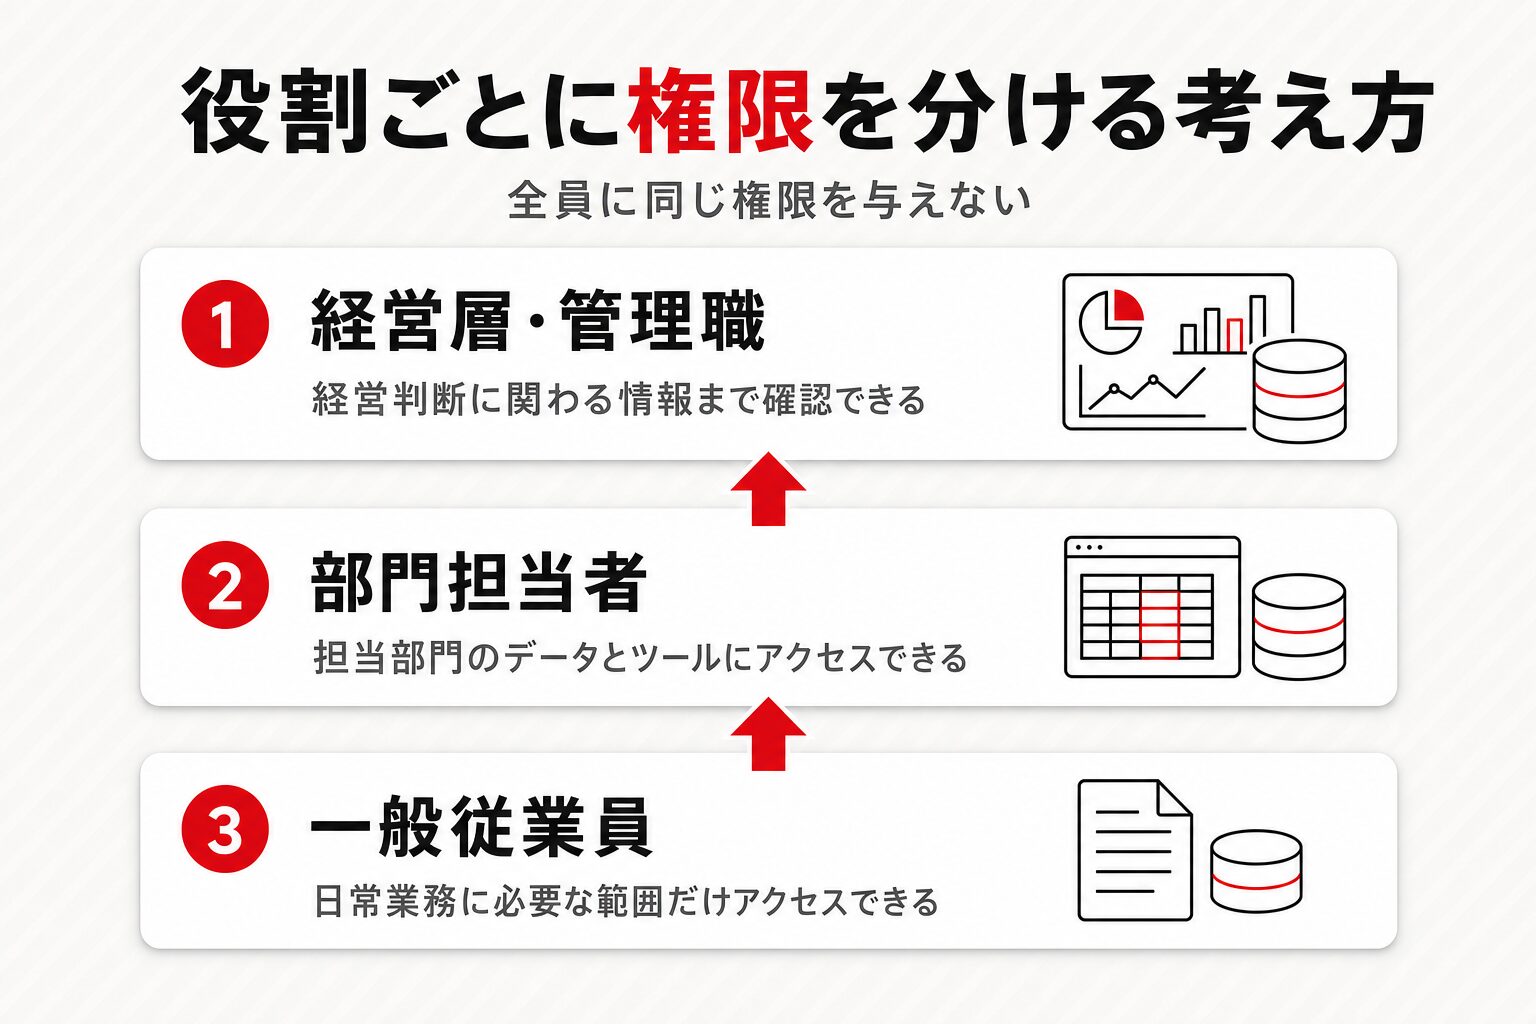
入力してよい情報の範囲を決めても、全員が同じ権限で生成AIを使える状態では管理が行き届きません。次に決めるべきは、誰が・どのツールを・どこまで使えるようにするかという権限設計です。
ここでは、組織として権限を分ける考え方と、各サービスの管理者機能を確認します。
全員に同じ権限を与えないという前提
生成AIの利用範囲は、経営層・部門担当者・一般従業員といった役割によって、本来必要な情報が異なります。全従業員に同じ権限を一律で与えるのではなく、役割に応じてアクセスできるツールやデータの範囲を分けるのが基本的な考え方です。
権限を絞る目的は、利用を制限することではなく、誰がどのデータに触れたかを後から追えるようにすることにあります。
管理者側で設定できる権限機能はサービスごとに違う
ChatGPT EnterpriseはSAML SSOとアクセス・利用機能のきめ細かな制御に対応し、Gemini(Workspace版)は既存のWorkspaceの保護がそのまま適用され、管理者は管理コンソールで既定設定を管理できます。
Copilot(商用版)が準拠するのは、Microsoft 365のプライバシー・セキュリティ・コンプライアンス上の既存の取り決めです。
出典:OpenAI「Enterprise privacy at OpenAI」
出典:Google Workspace「Generative AI in Google Workspace Privacy Hub」
出典:Microsoft Learn「Data, Privacy, and Security for Microsoft Copilot」
当社ではどう権限を分けているか
当社でも、AIエージェントごとにアクセスできるツールとデータの範囲を分けています。経理系のツールに触れるエージェントと、日程・情報共有を扱うエージェントとで権限を分離し、互いの担当範囲を越えてアクセスしない設計です。
権限を役割単位で管理すると、何かあったときの原因の切り分けもしやすくなります。
設定③保存・ログ:何を記録し、いつ・誰が確認するか
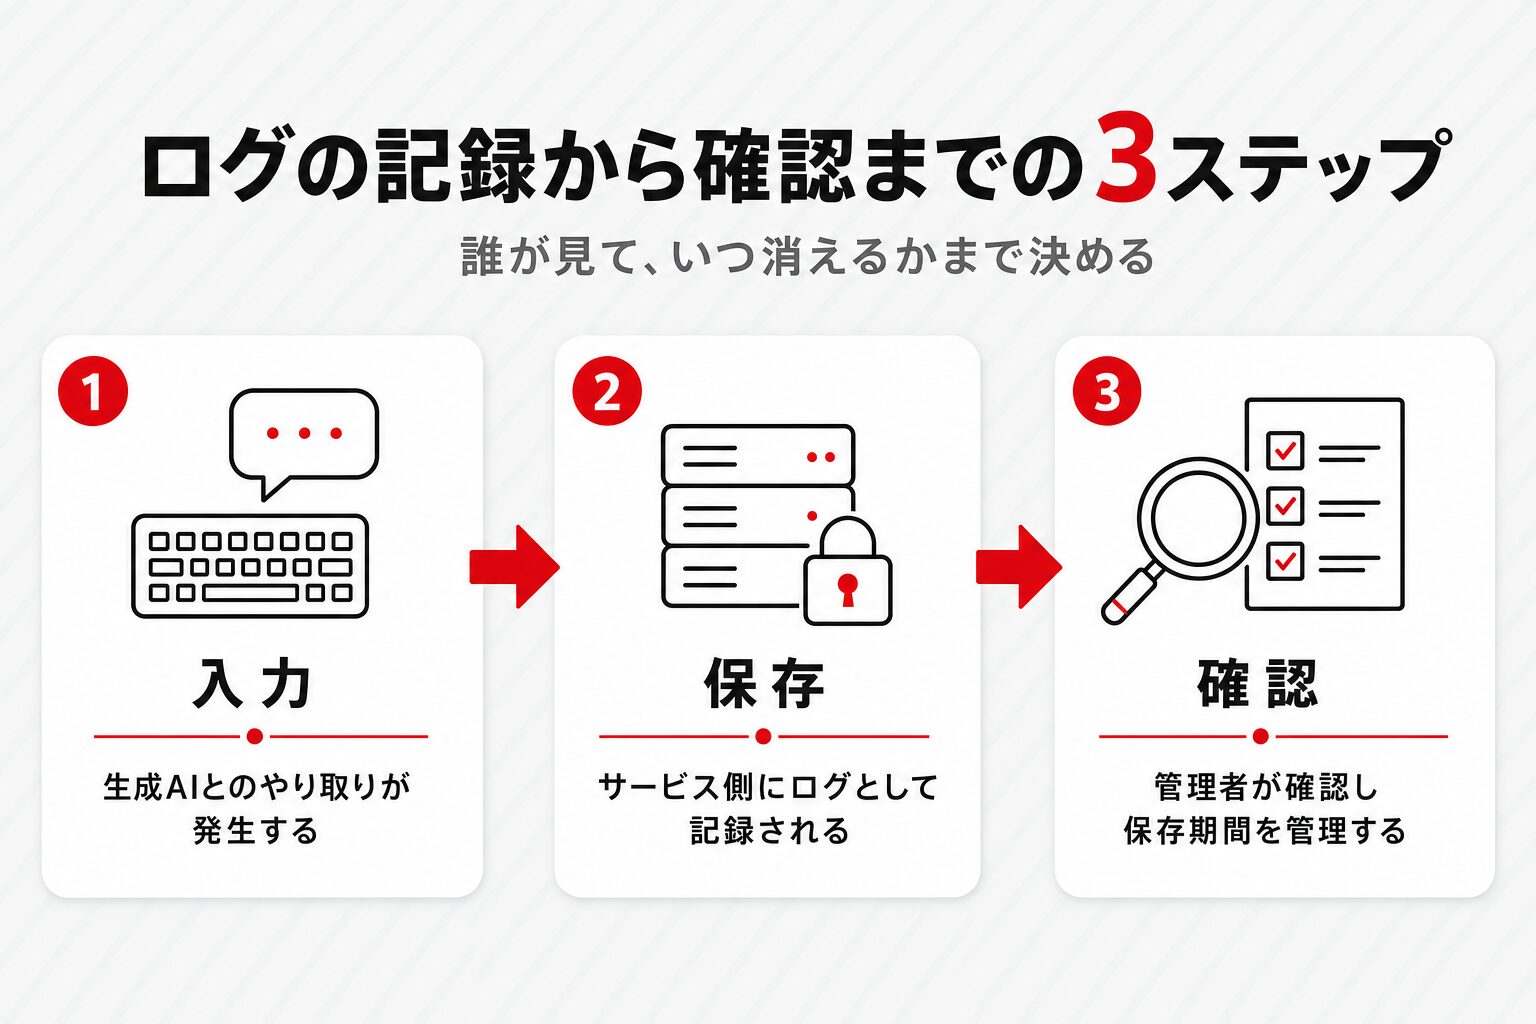
生成AIとのやり取りは、意識しなくてもサービス側にログとして記録されています。問題は記録の有無ではなく、誰がそのログを確認し、いつまで保存するのかという運用管理の設計です。
ここでは、各サービスの管理者向け機能と、当社での記録の残し方を紹介します。
ログを「取る」だけでなく「誰が見るか」まで決める
ChatGPT Enterpriseは、法令上の保持義務がある場合を除き、削除済みの会話が30日以内に消去され、会話とGPTの監査ログは管理者がEnterprise Compliance API経由で取得できます。Gemini(Workspace版)は会話履歴の自動削除期間を管理者が3・18・36か月や無期限から選べ、既定は18か月です。
ログは取るだけでなく、誰が見て、いつ消えるのかまで決めておきます。
出典:OpenAI「Enterprise privacy at OpenAI」
出典:Google Workspace「Generative AI in Google Workspace Privacy Hub」
当社ではどう記録を残しているか
当社でも、日々の情報共有や経営管理に関わるやり取りは記録が残る形で運用しています。誰が・いつ・どの業務のために確認した記録かが後から追える状態にしておくことを、社内の基本的な考え方としています。
記録そのものではなく、必要になったときに該当のやり取りへすぐ辿り着ける状態を保てているかが要点です。
設定④学習利用:オプトアウト設定をどう判断するか
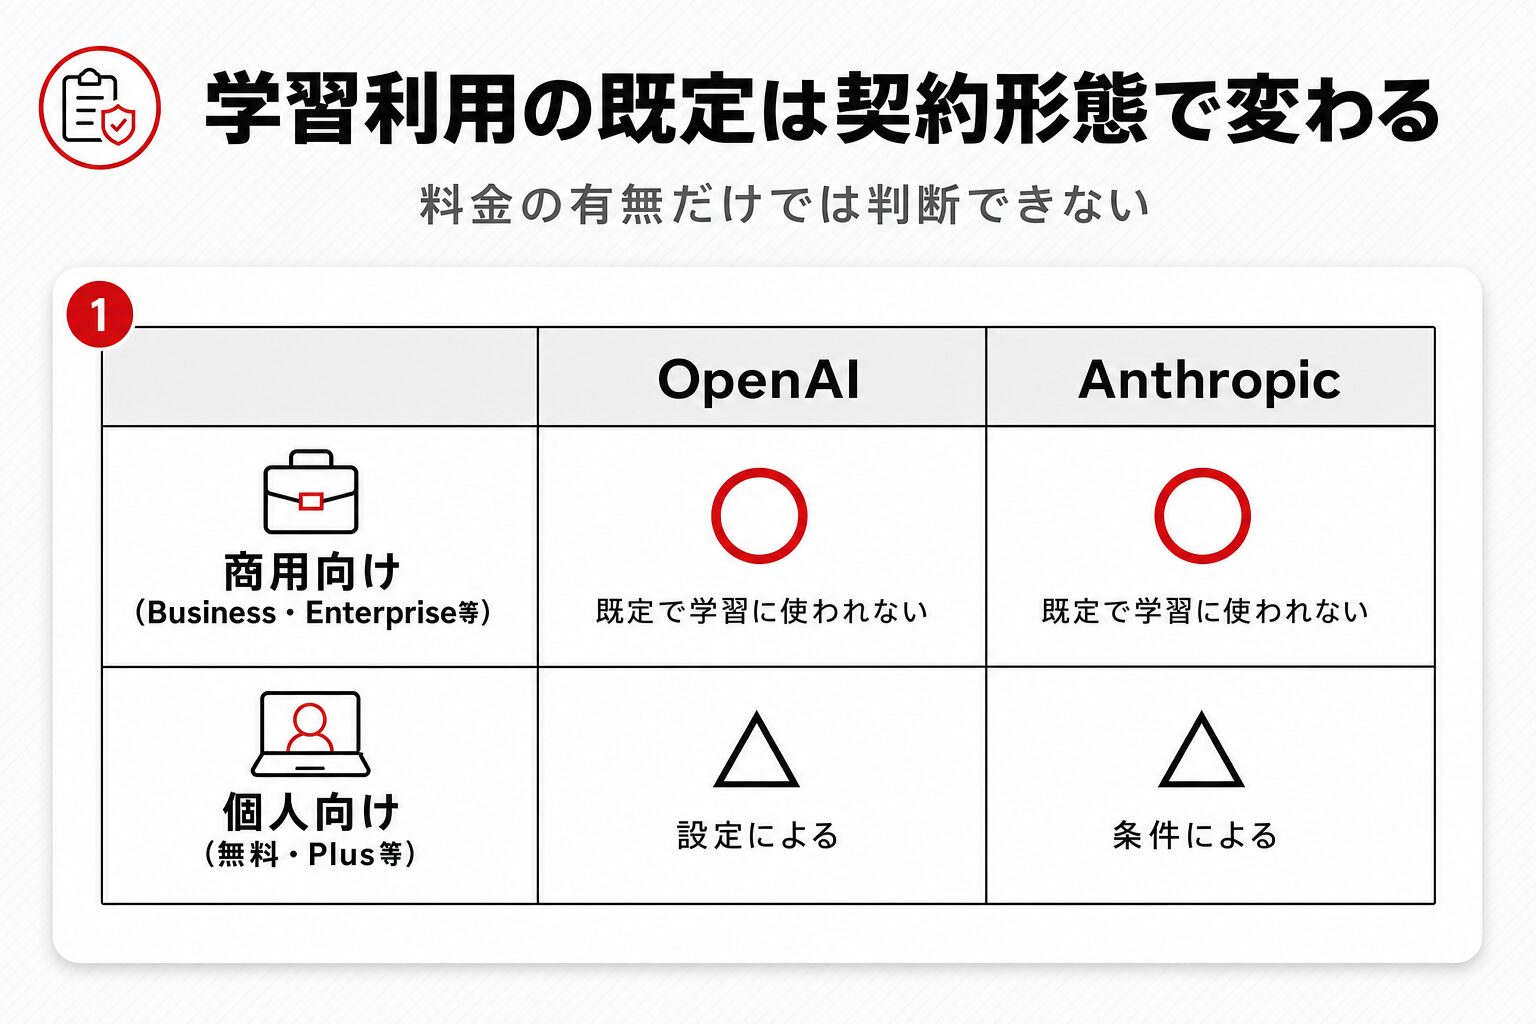
生成AIに入力した内容がモデルの学習に使われるかどうかは、サービスと契約形態、そして個々の設定によって変わります。「無料版だから」「有料プランだから」という料金の軸だけで判断すると、実態を見誤ります。
この章の要点は、判断の型と、設定変更の手順を探すときの見どころの2つです。
「無料版は使われる・有料版は使われない」という理解は不正確
OpenAIの商用向けは明示的に許可しない限り既定で学習に使われず、個人向けの無料・Plus等はオプトアウトしない限り学習に使われます。Anthropicの商用向け(Team・Enterprise等)も既定では学習に使われず、個人向けのFree・Pro・Maxプランはチャットとコーディングセッションが、モデル改善への利用を許可した場合や安全性審査の対象になった場合などに学習に使われます。
出典:OpenAI「Enterprise privacy at OpenAI」
出典:OpenAI「How your data is used to improve model performance」
出典:Anthropic Privacy Center「Is my data used for model training?」(商用向け)
出典:Anthropic Privacy Center「Is my data used for model training?」(消費者向け)
判断基準は「どの契約・どの設定でONになるか」
学習利用の可否を確かめる手順は、まず契約形態(個人向けか商用か)を見て、次にその契約でどの設定がオン・オフになっているかを見る、という2段階です。契約形態だけで安心せず、実際の設定画面で学習利用のトグルがどうなっているかまで確認することが欠かせません。
判断に迷ったら、契約している事業者の公式なプライバシーページを確認するのが確実です。
具体的なオフ設定の手順はこちら
実際の画面でどこを操作すればよいかは、ChatGPTに入力した内容、人間が読んでいます——三大AIの「学習オフ設定」を今すぐやるべき理由と全手順で、ChatGPT・Claude・Geminiの3サービス分をまとめて確認できます。
当社ではどう確認しているか
当社では、契約する生成AIサービスを選ぶ際、必ず学習利用条件を確認したうえで使い始めるようにしています。新しいツールを試す場合も、まずプライバシーポリシーで学習利用の既定値を確認してから、業務データを扱う範囲を決める順番です。
先に学習利用条件を確認してから業務データを扱う範囲を決めるのが、契約後に設定をやり直さずに済む順番です。
設定⑤外部連携先:どのツールと連携させるかを誰が決めるか
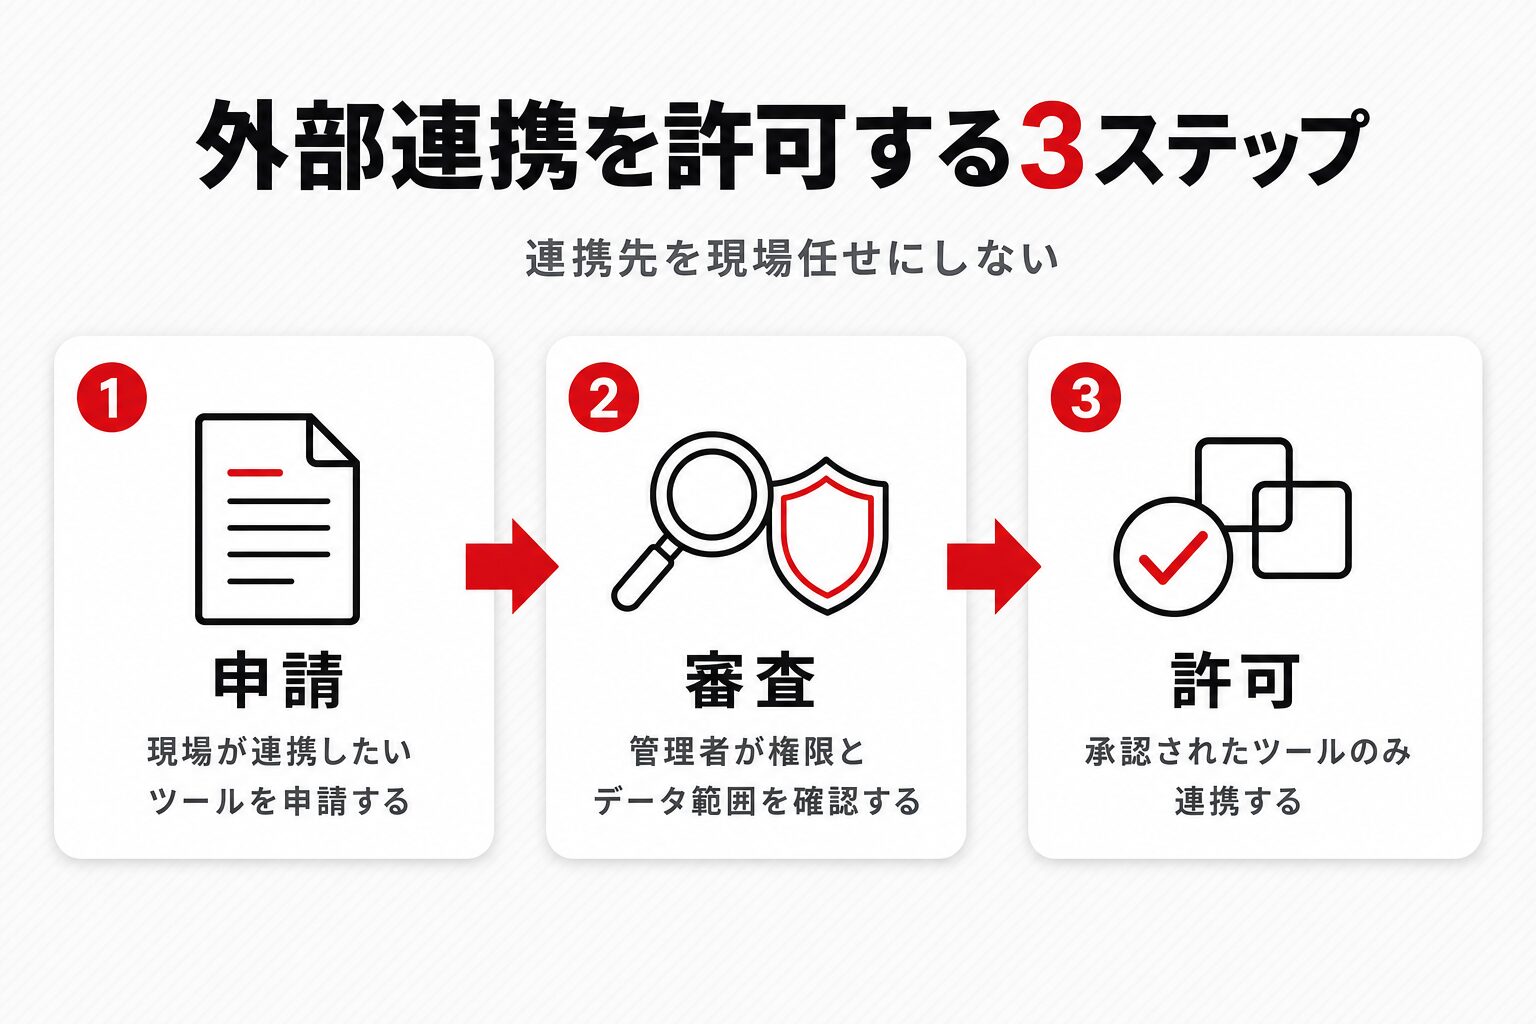
生成AIは、単体で使うだけでなく、会計ソフトやカレンダーなど外部ツールと連携させることで業務の自動化が進みます。ただし、どの外部ツールと連携させるかを現場任せにすると、権限や入力データの設定がいくら丁寧でも意味をなさなくなります。
鍵になるのは、外部連携先を誰がどう決めるかという視点です。
連携先を野放しにすると権限設定が意味をなさなくなる
ChatGPT Enterpriseのapps機能は管理者がワークスペースで有効化するアプリを選べ、Gemini(Workspace版)も管理者が組織のユーザーによるWorkspaceアプリへのアクセス可否を制御できる仕組みです。権限を役割ごとに分けていても、外部ツールとの連携先を野放しにすると、権限設定を通り抜けて情報が流出する経路ができてしまいます。
連携先の追加・変更は管理者の承認を通します。
出典:OpenAI「Enterprise privacy at OpenAI」
出典:Google Workspace「Generative AI in Google Workspace Privacy Hub」
当社ではどう連携先を絞っているか
当社では、経営管理を担うAIエージェントが会計ツール(freee)と連携し、売上・入金確認の一部を自動化しています。連携させるツールは限定しており、担当外のエージェントが会計データにアクセスできない設計にしている点がポイントです。
連携先を広げるかどうかは、業務上の必要性が明確になってから判断する方針です。
設定⑥人の承認:AIの出力をどこで人がチェックするか
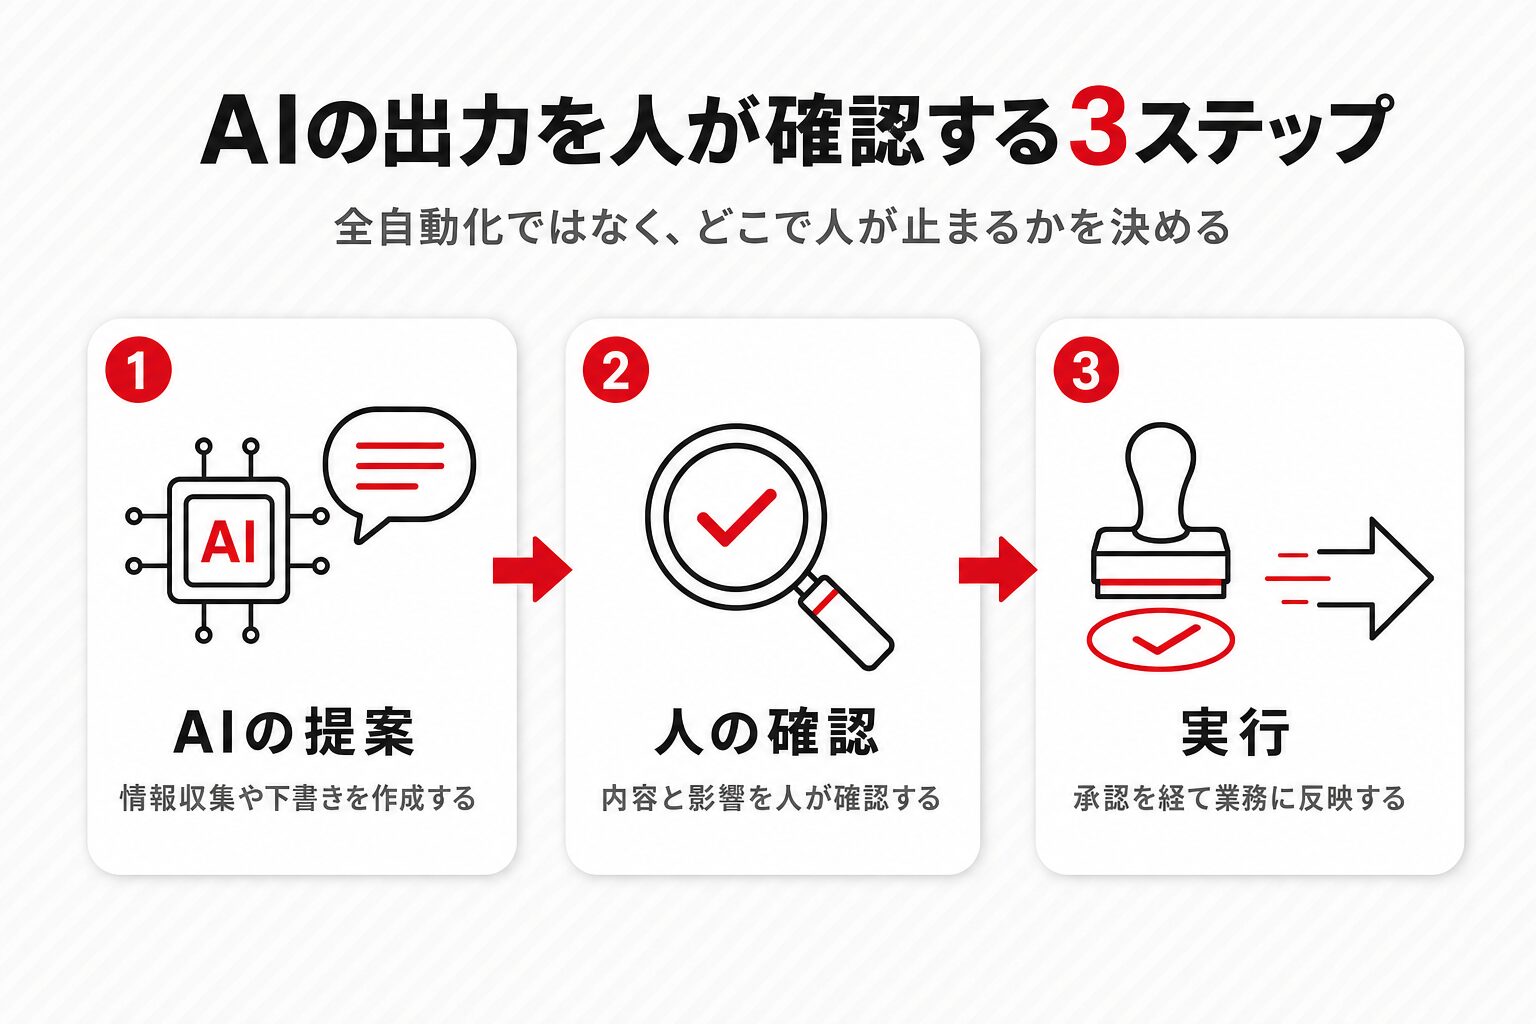
生成AIが作った文章や分析結果を、そのまま業務で使ってよいかどうかは、内容によって判断が分かれます。大切なのは全てを自動化することではなく、どの工程で人が出力を確認し、実行を承認するかをあらかじめ決めておくことです。
ここでは、人が止まるべき地点の決め方を整理します。
全自動化ではなく「どこで人が止まるか」を決める
AI事業者ガイドラインは、AIシステムの機密性・完全性・可用性を維持するため、その時点での技術水準に照らして合理的な対策を講じることを共通の指針として掲げています。出力の確認についても、金額の大きい判断や対外的な発信につながる場面など、影響の大きい業務から優先して人の確認工程を置くのが現実的な進め方です。
社内向けの下書きまで人が確認する体制にする必要はありません。
出典:総務省・経済産業省「AI事業者ガイドライン(第1.2版)」
当社ではどこで人が確認しているか
当社でも、AIエージェントが集めた情報や作成した数値をもとに、最終的な判断は人が行う体制にしています。特に金額に関わる確認や社外への発信は、AIが用意した情報を人が見てから実行する順番を崩していません。
AIに任せる範囲と人が引き取る範囲は、業務ごとに違う線引きです。
設定⑦インシデント対応:何かあったときに誰が・何をするか
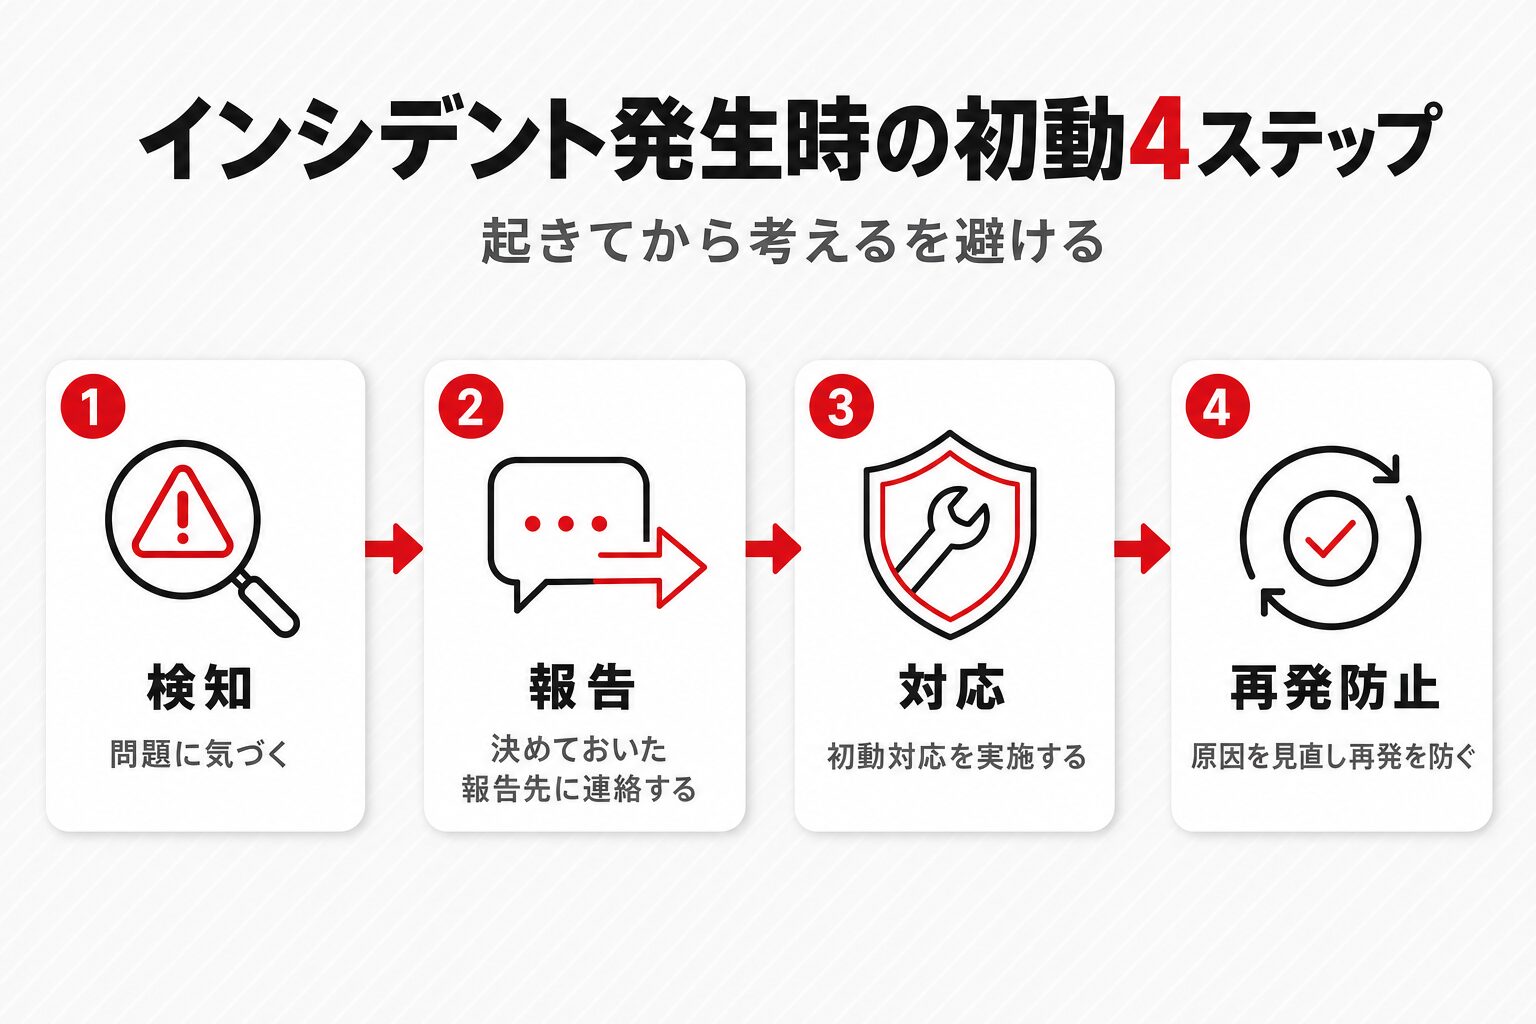
生成AIの利用に関して何らかのトラブルが起きたとき、誰に報告し、誰が初動を判断するのかを事前に決めていない組織は少なくありません。「起きてから考える」対応では、被害が広がってから動き出すことになりかねません。
取り上げるのは、あらかじめ決めておくべき項目と、当社の備え方です。
「起きてから考える」を避けるために先に決めておくこと
インシデント対応で先に決めておく項目は、報告先・初動対応・再発防止の見直しの3点に整理できます。誰が第一報を受けるか、該当データの削除依頼や関係者への連絡を誰の判断で行うかを、発生前に文書化しておくことがポイントです。
対応が後手に回るほど、被害の範囲は広がりやすくなります。
当社ではどう備えているか
当社が提供するOpenClaw導入支援には、機材調達から30日間のQAサポートまで8つの支援項目が含まれます。導入して終わりにせず、稼働後に不具合や疑問が出た際の相談先を先に用意しておくという考え方です。
通常は問い合わせから納品まで2〜3週間で進むため、その期間内にサポート体制の説明も済ませています。
設定を決めたら次にすること
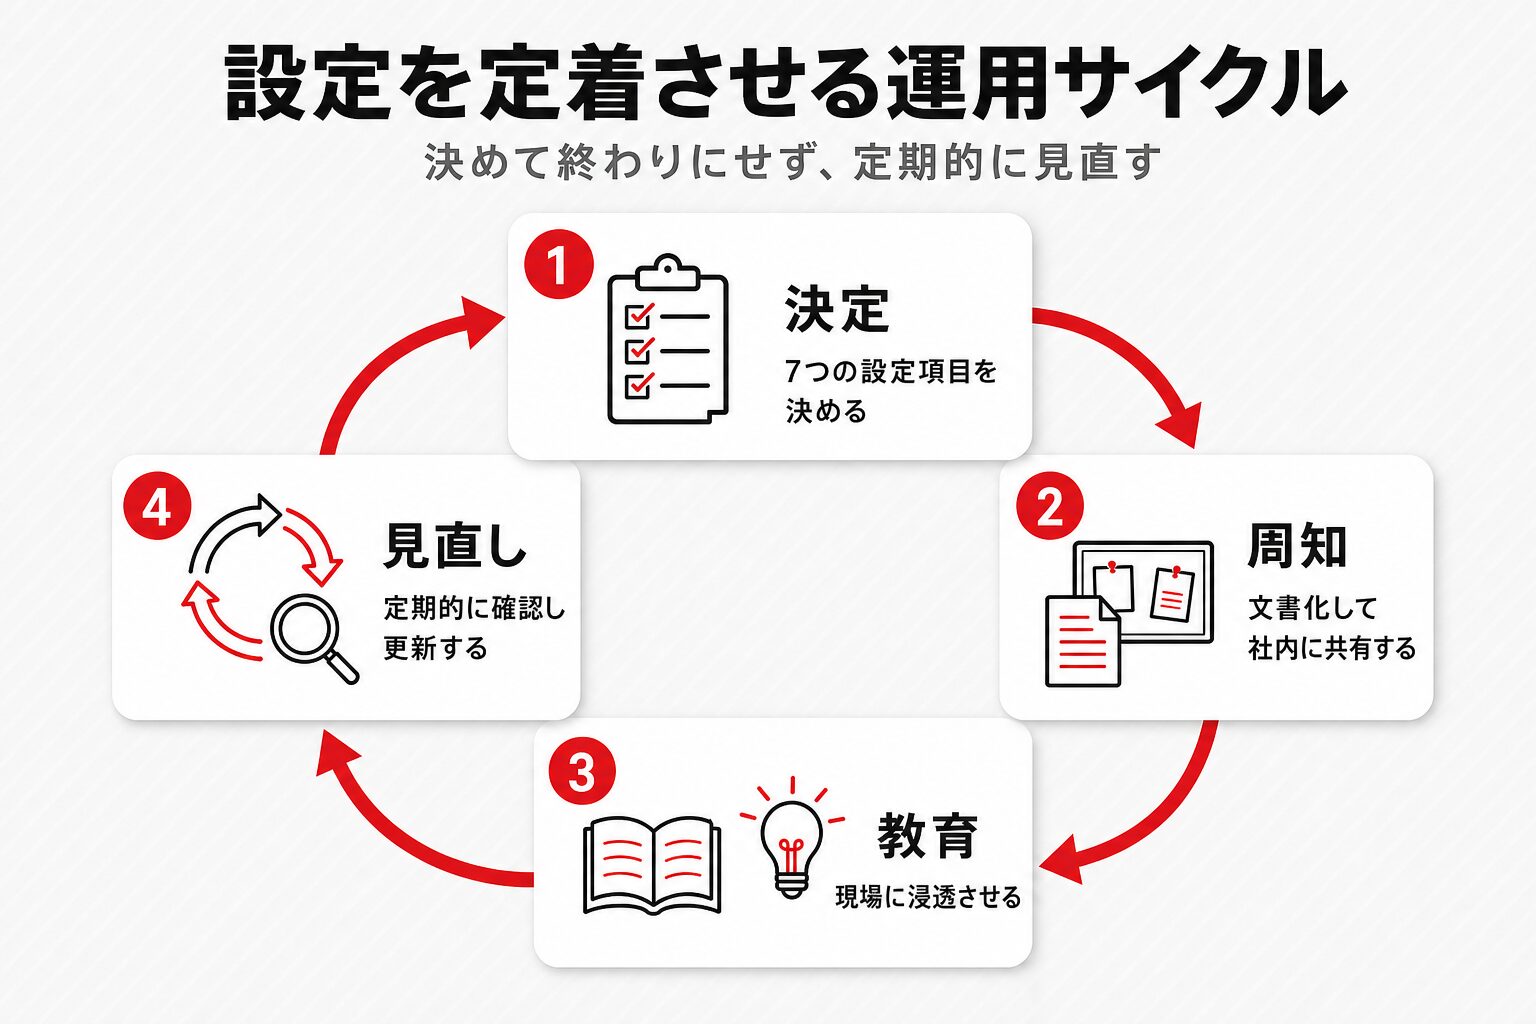
7つの設定項目を決めたとしても、決めただけで終われば、時間の経過とともに現場での運用は形骸化しやすくなります。次に必要なのは、決めた内容を文書として残し、周知と教育を通じて浸透させ、定期的に見直す運用のサイクルです。
ここでは、文書化以降の運用フェーズについて整理します。
決めた設定を文書にするのはこちらの記事の担当
決めた7つの設定を、条文や章立てとしてどう文書に落とし込むかは、社内規程の作成に踏み込む別のテーマです。本記事では判断基準の整理にとどめ、章立てやひな形の作り方は、生成AIガイドラインの作成を扱う別記事に譲ります。
まずは7項目について、自社としての判断を固めることを優先してください。
定期的に見直す仕組みを先に決めておく
生成AIのルールは、一度決めたら終わりではなく、見直すタイミングをあらかじめ決めておくことが定着の分かれ目です。公的なガイドラインの改定時や、契約するAIサービスの変更時、インシデント発生時などを見直しのきっかけとして事前に設定しておく方法があります。
見直しの手順を後回しにすると、ルール自体が形だけのものになりがちです。
当社ではどう見直しているか
当社は、外部イベントへの登壇を通じて、他社の生成AI活用の実態に触れる機会を持っています。そこで得た知見を自社の運用ルールの見直しに持ち帰るのが、当社の定例的な流れです。
他社の運用で見つけた穴は、自社ルールの追補として順次反映しています。
あなたのAI顧問について
あなたのAI顧問株式会社は、東京都品川区を拠点に、生成AIの導入支援とAIエージェントによる業務自動化を提供している会社です。代表の黒山は、営業現場で培った「お客様の課題を聞く力」、エンジニアとして身につけた技術的な実装力、ベンチャー立ち上げの経験から得た経営視点での優先順位付けという3つの軸を持っています。
当社自身もAIエージェントと組み合わせて日々の業務を運用しており、そこで得た知見をもとに支援を行っています。
生成AIのセキュリティ設定を自社でどう決めればよいか整理したい方は、資料ダウンロード|あなたのAI顧問から判断材料をご確認ください。会社概要はあなたのAI顧問株式会社の会社概要をご覧ください。
生成AIのセキュリティについてよくある質問
Q1. 生成AIのセキュリティ設定はどうすればいいですか?
生成AIのセキュリティは、データ範囲・権限・保存とログ・学習利用条件・外部連携先・人の承認・インシデント対応という7つの設定項目を、1つずつ決めることで担保できます。契約するサービスや契約形態によって既定の扱いが異なるため、公式のプライバシーページで確認しながら、自社の運用ルールに落とし込むことが基本の進め方です。
Q2. 生成AIで入力してはいけない情報は?
生成AIに入力してはいけない情報は、取引先の機密情報や、本人の同意を得ていない個人データ、営業秘密として管理している技術情報などです。個人情報保護委員会は、個人情報を含むプロンプトの入力について、利用目的の範囲内であることを十分に確認するよう求めています。
判断に迷う情報は、入力前に上長や情報管理の担当者に確認してから使う流れにしておきます。
出典:個人情報保護委員会「生成AIサービスの利用に関する注意喚起等について」
Q3. 生成AIのセキュリティガイドラインとは?
生成AIのセキュリティガイドラインとは、社内で入力してよい情報の範囲や、出力を確認する手順などをまとめた社内規程です。AI事業者ガイドラインなど公的な指針を土台に、自社の業務実態に合わせて条項を作成します。
具体的な章立てや作成手順は、社内規程づくりを専門に扱う別記事の領分です。
出典:総務省・経済産業省「AI事業者ガイドライン(第1.2版)」
Q4. 生成AIで情報漏洩しないようにするにはどうすればいいですか?
生成AIによる情報漏洩を防ぐには、入力してよい情報の範囲を決め、権限を役割ごとに分け、学習利用条件を確認したうえで契約するという3点が土台になります。加えて、外部ツールとの連携先を管理者が把握し、何かあった際の報告先をあらかじめ決めておくことも欠かせません。
設定を1つずつ積み重ねる考え方が、結果的に漏洩を防ぐ最も確実な方法です。
Q5. 生成AIのセキュリティ対策は?
生成AIのセキュリティ対策の柱は、入力データの範囲、利用権限、保存とログ、学習利用条件、外部連携先、人の承認、インシデント対応の7つです。業界共通の正解が1つあるわけではなく、自社の業務内容と情報の重要度に応じて、どこまで厳格にするかを決める作業になります。
自社の現状がどこまで決まっているかを棚卸しするところが出発点です。
まとめ:生成AIのセキュリティは設定項目ごとに決めて安全に活用しよう
生成AIのセキュリティは、使うか使わないかの二択ではなく、7つの設定項目を1つずつ決め切ることで担保できます。データ範囲・権限・保存とログ・学習利用条件・外部連携先・人の承認・インシデント対応の7項目で考えること、サービスや契約形態によって担保できる内容が違うため一律の思い込みで判断しないこと、決めて終わりにせず定期的に見直すことの3点を押さえておくと、判断に迷いにくくなります。
まずは自社の設定がどこまで決まっているかを洗い出し、資料ダウンロード|あなたのAI顧問で判断材料を確認してみてください。
WRITERライター紹介
黒山結音
あなたのAI顧問株式会社 代表取締役
「AIは現場で使えなきゃ意味がない」を掲げ、30社以上にAI顧問として導入から定着までサポート。OpenClaw・Claude・ChatGPTなどAIツールを実務でフル活用し、AI駆動経営を実践。本メディアでは、実際の現場で効果が出た事例や、AI初心者がつまずく「最初の一歩」を、専門用語を極力使わずに解説します。
OpenClaw / Claude Code / Codex / Cursor / Manus
この記事をシェアする